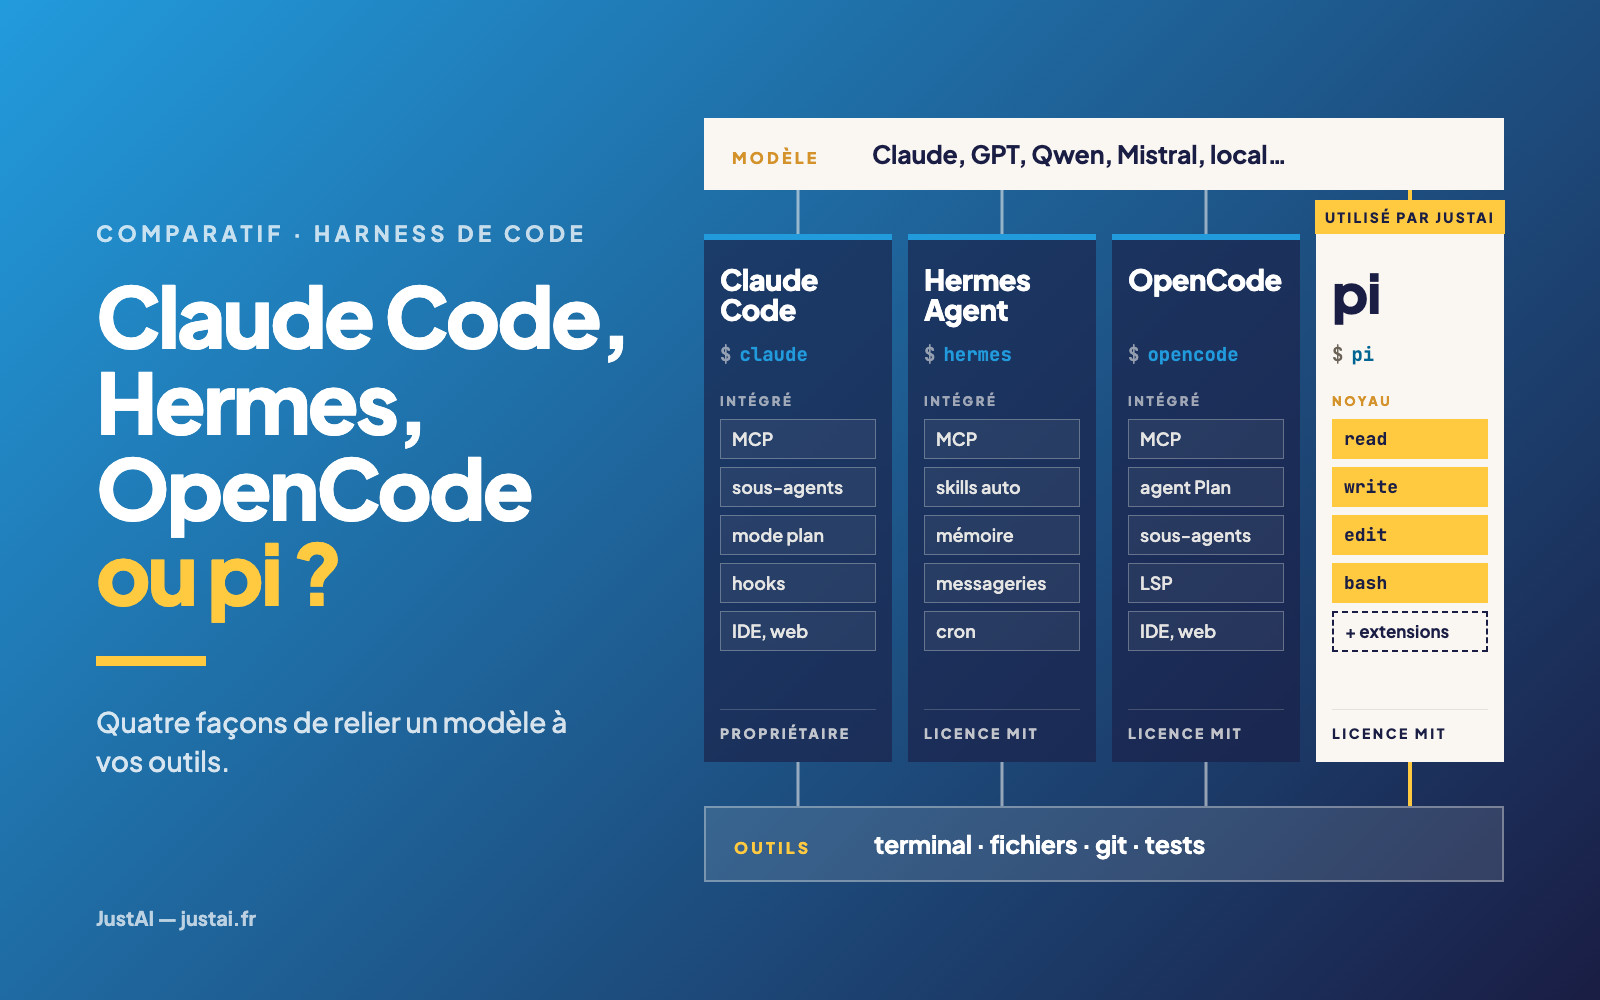
Ce qu'il faut retenir
- Claude Code est le harness propriétaire d'Anthropic : le runtime qui relie les modèles Claude aux outils de développement (terminal, fichiers, git, MCP). Il réunit sous un même éditeur IDE, bureau, web, mobile, CI/CD et administration d'équipe, mais il est conçu pour les seuls modèles Claude.
- Hermes Agent, de Nous Research, est un harness généraliste open source (licence MIT) : il code, mais il automatise aussi des tâches, mémorise et répond depuis Telegram, Slack ou Microsoft Teams. Sa boucle d'apprentissage, qui crée et améliore des skills à l'usage, reste sa marque de fabrique.
- OpenCode, édité par Anomaly, est un harness de développement open source (MIT) agnostique sur les modèles : plus de 75 fournisseurs, des agents Build et Plan, des sous-agents, une interface web, une intégration GitHub et GitLab, et un éditeur qui ne stocke ni le code ni le contexte.
- pi est un harness de code minimaliste (MIT) que l'on étend soi-même : quatre outils de base, ni MCP, ni sous-agents, ni mode plan intégrés, mais un système d'extensions TypeScript, de skills et de paquets. C'est le harness que JustAI utilise en ce moment, avec des extensions internes, parce que nous y observons une bien meilleure gestion du cache des tokens.
- Le critère de choix reste stratégique : dépendance fournisseur, localisation des données, recours possible à des modèles locaux, gouvernance d'équipe et, de plus en plus, maîtrise du contexte et du cache, qui pèsent directement sur la facture d'inférence.
Harness, orchestrateur, agent : de quoi parle-t-on exactement ?
Avant de comparer, il faut poser le vocabulaire. En 2026, le marché emploie des termes interchangeables qui désignent des choses distinctes :
- Le LLM (Claude Opus, GPT-5, Mistral Large, Qwen) est le modèle de langage. Il génère du texte et du code, il raisonne. Mais seul, il ne peut ni lire un fichier, ni exécuter une commande, ni créer une pull request.
- Le harness (ou orchestrateur) est l'infrastructure qui entoure le LLM et le rend opérationnel : il expose des outils (bash, édition de fichiers, recherche, LSP, web), gère le contexte (fichiers de projet, mémoire, conventions), contrôle les permissions (qui peut exécuter quoi) et orchestre la boucle d'exécution (le LLM propose une action, le harness l'exécute, le résultat revient au LLM). C'est le runtime.
- L'agent est le LLM opérant à l'intérieur du harness. Quand Claude Code exécute une tâche complexe, l'agent est le modèle Claude qui agit au moyen des outils que le harness met à sa disposition. L'agent n'existe pas sans le harness.
Claude Code, Hermes Agent, OpenCode et pi sont donc quatre harness : quatre runtimes qui connectent un LLM à un ensemble d'outils et orchestrent son travail. Leur principe est le même ; ils diffèrent par l'étendue des outils exposés, la gouvernance, les modèles pris en charge et la philosophie de conception. Ce choix n'est pas neutre : selon les résultats publiés par Prime Intellect, un même modèle est passé de 30,2 % à 95,5 % sur le benchmark ARC-AGI-3 en changeant seulement de harness, comme nous l'avons détaillé dans notre analyse de Prime Agent.
Le développement logiciel assisté par IA a basculé en 2026. Les assistants d'autocomplétion de 2024 (GitHub Copilot, Tabnine) ont cédé la place à des harness capables d'orchestrer des workflows autonomes : lire un codebase entier, planifier une tâche, modifier plusieurs fichiers, exécuter des tests et créer des pull requests sans intervention humaine continue.
Ce comparatif retient quatre harness qui ne résolvent pas le même problème :
- Claude Code est un harness de développement verticalement intégré à l'écosystème Anthropic.
- Hermes Agent est un harness généraliste qui sait coder, mais aussi automatiser, apprendre et communiquer par messagerie.
- OpenCode est un harness de développement open source, agnostique sur les modèles et centré sur la confidentialité.
- pi est un harness de développement minimaliste, dont chaque équipe construit les fonctions avancées par ses propres extensions.
| Critère | Claude Code | Hermes Agent | OpenCode | pi |
|---|---|---|---|---|
| Nature | Harness de développement | Harness généraliste | Harness de développement | Harness de développement minimaliste |
| Éditeur | Anthropic | Nous Research | Anomaly | Mario Zechner, dépôt earendil-works |
| Licence | Propriétaire | MIT | MIT | MIT |
| Modèles | Claude (via Anthropic, Amazon Bedrock, Google Cloud ou Microsoft Foundry) | Nous Portal (300+ modèles), OpenRouter, OpenAI, Anthropic, endpoints personnalisés | 75+ fournisseurs via Models.dev | Une trentaine de fournisseurs, abonnements, serveurs compatibles OpenAI |
| Étoiles GitHub (22/09/2026) | Code non publié | ≈ 248 000 | ≈ 209 000 | ≈ 108 000 |
| Interfaces | Terminal, VS Code, JetBrains, bureau, web, mobile | Terminal, bureau, web, IDE (ACP), messageries | Terminal, bureau (bêta), web, VS Code, ACP | Terminal ; modes RPC et SDK |
| Extensions | Plugins (skills, sous-agents, hooks, serveurs MCP) | Skills, plugins Python, hooks, MCP | Plugins JS/TS, agents, skills, MCP | Extensions TypeScript, skills, modèles de prompts, paquets |
| Prix | À partir de 20 $/mois (Claude Pro) | Gratuit + coût du modèle | Gratuit + coût du modèle | Gratuit + coût du modèle |
Mise à jour du 22 septembre 2026 : ajout de pi, chiffres actualisés et fonctions revérifiées dans la documentation officielle de chaque projet (versions Claude Code 2.1.278, Hermes Agent 0.21.4, OpenCode 1.18.32 et pi 0.87.0). Ces outils publient plusieurs versions par mois : vérifiez les points décisifs pour vous avant de trancher.
Ce comparatif s'adresse aux équipes techniques et aux DSI qui doivent arbitrer entre ces approches sans se limiter à une liste de fonctionnalités.
Claude Code : le harness verticalement intégré
Claude Code est le harness d'Anthropic, lancé en 2025. Il se présente comme un CLI installé dans le terminal, complété par des extensions VS Code et JetBrains, une application de bureau (macOS et Windows, Linux en bêta), une interface web sur claude.ai/code et l'application mobile Claude pour iOS et Android. Anthropic le qualifie d'« agentic coding tool » : un outil qui lit un codebase, édite des fichiers, exécute des commandes et s'intègre aux outils de développement.
Sa distribution par npm lui a d'ailleurs valu un épisode marquant : en mars 2026, le code source complet de Claude Code a fuité via un fichier source map, un rappel des risques qui pèsent sur la chaîne de distribution logicielle.
Forces
- Harness et modèles conçus ensemble : Anthropic développe à la fois Claude Code et les modèles Claude (Opus, Sonnet), et fait évoluer le premier avec les seconds.
- CLAUDE.md et mémoire automatique : un fichier Markdown à la racine du projet donne des instructions persistantes (conventions de code, architecture, bibliothèques préférées) ; Claude Code lit aussi un
AGENTS.mdexistant quand le projet n'a pas de CLAUDE.md. Le harness construit en plus une mémoire automatique entre sessions, sans que l'utilisateur ait à écrire quoi que ce soit. - Écosystème MCP et plugins : le Model Context Protocol, standard ouvert initié par Anthropic, connecte le harness à Google Drive, Jira, Slack ou des outils internes. C'est le MCP qui rend l'outil opérationnel en entreprise. Les plugins regroupent skills, sous-agents, hooks et serveurs MCP, et se partagent par des places de marché.
- CI/CD et tâches planifiées : Claude Code s'exécute dans GitHub Actions et GitLab CI/CD (en bêta) pour automatiser les revues de code, le triage d'issues et la création de pull requests. Les routines, en aperçu de recherche, tournent sur l'infrastructure d'Anthropic, même machine éteinte, et se déclenchent selon un calendrier, par appel d'API ou sur un événement GitHub.
- Sous-agents : le harness délègue des sous-tâches à des sous-agents ; les équipes d'agents, expérimentales et désactivées par défaut, coordonnent plusieurs sessions Claude Code. L'Agent SDK permet de construire des workflows sur mesure.
- Travail à distance : Remote Control pilote une session locale depuis un téléphone ou un navigateur,
@Claudereçoit des tâches dans Slack, et les channels (aperçu de recherche) relaient Telegram, Discord et iMessage vers une session ouverte. - Administration d'équipe : les offres Team et Enterprise ajoutent SSO, facturation centralisée et paramètres gérés côté serveur ; Enterprise ajoute des permissions par rôle et une API de conformité.
Limites
- Conçu pour les seuls modèles Claude : Claude Code fonctionne avec les modèles d'Anthropic, servis par Anthropic, Amazon Bedrock, Google Cloud ou Microsoft Foundry. Des passerelles compatibles avec l'API d'Anthropic permettent techniquement d'y brancher d'autres modèles : Ollama documente ainsi
ollama launch claudepour des modèles locaux ou hébergés. Mais Anthropic précise ne pas prendre en charge l'usage de modèles non-Claude à travers une passerelle. - Coût : il faut un abonnement Claude Pro (20 $/mois, 17 $ en facturation annuelle), Max (à partir de 100 $/mois), Team (25 $ par siège standard et par mois, 20 $ en annuel), Enterprise, ou une facturation à l'usage. Selon la documentation d'Anthropic, le coût moyen observé dans les déploiements en entreprise tourne autour de 13 $ par développeur et par jour actif, et de 150 à 250 $ par développeur et par mois.
- Souveraineté des données : en direct, le code et le contexte transitent par Anthropic, société américaine. Les données sont conservées 30 jours en offre commerciale (Team, Enterprise, API) ; une conservation nulle est possible sur Enterprise, pour les comptes éligibles. Sur les offres individuelles (Pro, Max), la durée passe de 30 jours à cinq ans si l'utilisateur accepte que ses données servent à améliorer les modèles. Pour garder l'inférence en Europe, il faut passer par un fournisseur cloud (Google Cloud propose par exemple un point de terminaison multirégion
eu), sous réserve que les modèles voulus y soient disponibles ; ces fournisseurs restent eux aussi américains. - Code fermé : le harness n'est pas auditable. Seule la fuite de mars 2026 en a exposé le code.
Hermes Agent : le harness généraliste qui sait coder
Hermes Agent est développé par Nous Research, laboratoire de recherche en IA connu pour ses modèles open source (Hermes 3, Hermes 4). Au 22 septembre 2026, son dépôt GitHub compte 247 967 étoiles et 52 268 forks, ce qui en fait le plus étoilé des trois harness open source de ce comparatif.
La distinction importante : Hermes n'est pas un harness dédié au développement logiciel. C'est un harness généraliste qui expose plus de 40 outils (terminal, édition de fichiers, recherche web, navigateur, génération d'images, synthèse vocale, tâches planifiées, délégation de sous-tâches). Il écrit du code, mais il automatise aussi des tâches système, fait de la recherche, gère des workflows, communique par messagerie et apprend de ses interactions. Le développement logiciel est un de ses usages, pas le seul.
Forces
- Boucle d'apprentissage fermée : c'est sa principale différence. Hermes crée des skills de lui-même après avoir résolu des tâches complexes, les améliore à l'usage et conserve sa mémoire entre sessions, avec une recherche plein texte (FTS5) dans les conversations passées. Il tient aussi un profil de l'utilisateur (
USER.md), que des fournisseurs de mémoire externes, en option, comme Honcho, peuvent approfondir. - Messagerie multiplateforme : une passerelle unique relie Hermes à Telegram, Discord, Slack, WhatsApp, Signal, l'e-mail, Microsoft Teams, Home Assistant et d'autres (Matrix, Mattermost). On peut lancer une tâche depuis son téléphone et recevoir le résultat dans la même conversation.
- Agnostique sur les modèles : Nous Portal (300+ modèles), OpenRouter, OpenAI, Anthropic, Amazon Bedrock, Google Vertex AI ou un endpoint personnalisé. On change de modèle avec
hermes model, et une chaîne de fournisseurs de repli, à configurer, prend le relais en cas d'erreur. - Modèles locaux intégrés : l'application de bureau télécharge et gère le moteur llama.cpp, et choisit la version de chaque modèle adaptée à la machine. Hermes se branche aussi sur Ollama, LM Studio, vLLM ou SGLang.
- Sept backends d'exécution : local, Docker, SSH, Singularity, Modal, Daytona et Vercel Sandbox. Modal et Daytona offrent une persistance serverless : l'environnement hiberne quand il est inactif et se réveille à la demande, ce qui ramène le coût presque à zéro entre les sessions.
- Bureau, web et IDE : Hermes Desktop est une application officielle (macOS sur Apple Silicon, Windows et Linux),
hermes dashboardouvre une interface web (configuration, clés, sessions, onglet de discussion) ethermes acpintègre l'agent à VS Code, Zed et JetBrains. - Skills et plugins : Hermes est compatible avec le standard ouvert agentskills.io, pour partager des compétences entre équipes. Des plugins en Python ajoutent des outils, des hooks, des intégrations, des fournisseurs de mémoire ou des moteurs de contexte.
- Orienté recherche : génération de trajectoires en lot et compression de trajectoires pour entraîner de futurs modèles d'appel d'outils. C'est le seul des quatre qui se présente aussi comme un instrument de recherche.
Limites
- Pas conçu d'abord pour le développement : le mode ACP expose dans l'éditeur un jeu d'outils réduit, avec diffs et approbations, mais l'essentiel du produit (messagerie, cron, mémoire, génération d'images) vise des usages généraux.
- Installation plus lourde : l'installeur gère uv, Python 3.11, Node.js, ripgrep et ffmpeg, plus un Git Bash portable sous Windows quand Git est absent. L'installeur de Hermes Desktop simplifie la démarche sur macOS et Windows. Notre tutoriel d'installation d'Hermes Agent décrit la procédure pas à pas.
- Qualité du code liée au modèle choisi : Hermes n'est pas réglé pour une famille de modèles en particulier, là où Claude Code est développé avec les modèles Claude.
- Gouvernance d'équipe limitée : le « Managed Scope » permet à un administrateur de figer une partie de la configuration et des secrets sur un poste (
/etc/hermes), sans que l'utilisateur puisse les modifier. En revanche, la documentation ne décrit ni SSO ni console centrale pour une équipe, et seules les commandes jugées dangereuses sont soumises à approbation.
OpenCode : le harness de développement open source pensé pour la vie privée
OpenCode est édité par Anomaly (l'organisation GitHub anomalyco) sous licence MIT. Au 22 septembre 2026, son dépôt compte 209 310 étoiles ; l'éditeur revendique sur son site 950 contributeurs et 16 millions de développeurs par mois. Son positionnement : confidentialité d'abord, agnostique sur les modèles, présent sur plusieurs surfaces.
OpenCode fonctionne dans le terminal, dans une application de bureau (bêta), dans le navigateur (opencode web), dans VS Code et ses dérivés (Cursor, Windsurf, VSCodium), et dans les éditeurs compatibles ACP (opencode acp). Il embarque deux agents principaux, Build (tous les outils) et Plan (modifications et commandes soumises à confirmation), entre lesquels on bascule avec la touche Tab. Il ajoute trois sous-agents : General, Explore et Scout, que l'agent principal appelle lui-même ou que l'utilisateur invoque par une mention @. General sert notamment à mener plusieurs tâches en parallèle. Tous ces agents sont configurables : modèle, permissions, prompt, température. Pour l'installer et le configurer pas à pas, suivez notre tutoriel d'installation d'OpenCode.
Forces
- Aucun stockage chez l'éditeur : OpenCode ne stocke ni code ni contexte sur ses serveurs. Le traitement a lieu sur le poste ou par appel direct au fournisseur du modèle. Seule exception, la fonction de partage
/share, que l'on peut désactiver pour toute l'équipe ("share": "disabled"). - 75+ fournisseurs de modèles via Models.dev, dont des modèles locaux (Ollama, LM Studio, llama.cpp). On peut aussi utiliser un abonnement GitHub Copilot ou ChatGPT Plus/Pro existant.
- LSP intégré : le harness charge automatiquement les bons serveurs de langage (LSP) pour aider le modèle à naviguer dans le code.
- Multi-session : plusieurs agents peuvent travailler en parallèle sur le même projet.
- Agents, plugins et skills configurables : on crée des agents sur mesure en JSON ou en Markdown (auditeur de sécurité, rédacteur de documentation) ; des plugins en JavaScript ou TypeScript, locaux ou publiés sur npm, s'accrochent aux événements du harness ; skills et serveurs MCP sont pris en charge.
- CI/CD :
opencode runfonctionne sans interface.opencode github installinstalle un agent qui tourne dans GitHub Actions, déclenché par un commentaire/opencode, une pull request ou un calendrier cron. GitLab CI (via un composant communautaire) et GitLab Duo sont également documentés. - Configuration gérée : un administrateur peut imposer une configuration que l'utilisateur ne peut pas contourner (
/etc/opencodesous Linux, profil.mobileconfigdéployé par MDM sur macOS). L'offre Enterprise, facturée par siège sur devis, ajoute une configuration centrale reliée au SSO et à une passerelle IA interne.
Limites
- Pas de mémoire automatique : OpenCode ne documente pas de mémoire construite entre sessions. Le fichier
AGENTS.mdporte les instructions du projet, et les sessions, stockées sur le poste, peuvent être reprises. - Pas de passerelle de messagerie documentée : ni Telegram ni Discord, et seulement un bot Slack présent dans le dépôt, à lancer soi-même, que la documentation ne décrit pas. Le harness vit dans le terminal, l'IDE, le bureau ou le navigateur.
- Permissions permissives par défaut : sans configuration, la plupart des actions (édition, bash) sont autorisées sans confirmation ; seuls l'accès à des dossiers extérieurs au projet et les boucles répétitives déclenchent une demande. Les règles sont à fixer avant un déploiement.
- Partage public : un lien
/shareest accessible à toute personne qui le détient, et la conversation est synchronisée sur les serveurs d'opencode.ai. - Pas d'abonnement Claude : la documentation d'OpenCode rappelle qu'Anthropic interdit d'utiliser un abonnement Claude Pro ou Max avec OpenCode par des plugins tiers. Les modèles Claude restent accessibles par clé d'API.
pi : le harness minimaliste que l'on construit soi-même
pi se présente comme un « harness de code minimaliste » pour le terminal, sous licence MIT. Lancé en 2025 par Mario Zechner dans le dépôt badlogic/pi-mono, le projet est désormais hébergé dans earendil-works/pi, et l'ancienne adresse redirige vers la nouvelle. Le paquet npm a changé de nom : l'ancien @mariozechner/pi-coding-agent est marqué obsolète au profit de @earendil-works/pi-coding-agent. Au 22 septembre 2026, le dépôt compte 108 422 étoiles.
Sa devise tient en une phrase de son README : adapter pi à ses workflows, et non l'inverse, sans avoir à forker le projet. Par défaut, pi ne donne au modèle que quatre outils : read, write, edit et bash. Trois outils en lecture seule (grep, find, ls) peuvent s'y ajouter pour une revue de code sans modification. Son auteur explique ce choix par l'ingénierie du contexte : maîtriser exactement ce qui entre dans le contexte du modèle, et voir tout ce que fait l'agent.
Ce que pi n'intègre volontairement pas
pi écarte délibérément plusieurs fonctions que les autres harness intègrent :
- pas de MCP : l'auteur préfère des outils en ligne de commande documentés par un README, que l'agent lit seulement quand il en a besoin ; une extension peut ajouter MCP ;
- pas de sous-agents : on lance d'autres instances de pi (par exemple dans tmux) ou on les construit par extension ;
- pas de fenêtres de permission : on isole pi dans un conteneur, ou on écrit son propre flux de confirmation ;
- pas de mode plan ni de liste de tâches intégrée : on écrit le plan dans un fichier, ou on installe un paquet ;
- pas de bash en arrière-plan : tmux remplit ce rôle, avec une visibilité complète.
Le système d'extensions de pi
C'est le cœur du projet. pi se personnalise à quatre niveaux, que l'on peut regrouper et partager :
- Les extensions TypeScript sont des modules chargés depuis
~/.pi/agent/extensions/(pour tous les projets) ou.pi/extensions/(pour un projet), rechargeables à chaud avec/reload. D'après la documentation, une extension peut enregistrer des outils appelables par le modèle, ou remplacer les outils intégrés ; ajouter des commandes (/macommande), des raccourcis clavier et des options de ligne de commande ; s'abonner aux événements du cycle de vie pour bloquer ou modifier un appel d'outil, réécrire le contexte avant chaque appel au modèle, personnaliser la compaction ou inspecter la requête envoyée au fournisseur ; construire de l'interface (dialogues, widgets, barre d'état, pied de page, éditeur personnalisé) ; déclarer de nouveaux fournisseurs de modèles ; conserver un état dans la session. La documentation cite en exemples des sous-agents, un mode plan, des garde-fous avantrm -rf, la protection de fichiers comme.env, des points de sauvegarde git, l'exécution par SSH ou en sandbox et l'intégration MCP. - Les skills suivent le standard Agent Skills : l'agent les charge quand il en a besoin, ou on les appelle avec
/skill:nom. - Les modèles de prompts (fichiers Markdown appelés par
/nom) et les thèmes complètent l'ensemble. - Les paquets pi regroupent extensions, skills, prompts et thèmes, et se publient sur npm ou git. On les installe avec
pi install npm:…oupi install git:…, en épinglant une version si besoin, pour tous les projets ou pour un seul (-l) ;pi configactive ou désactive chaque ressource.
Une extension minimale tient en quelques lignes. Celle-ci, tirée de la documentation, demande une confirmation avant toute commande rm -rf :
import type { ExtensionAPI } from "@earendil-works/pi-coding-agent";

export default function (pi: ExtensionAPI) {
  pi.on("tool_call", async (event, ctx) => {
    if (event.toolName === "bash" && event.input.command?.includes("rm -rf")) {
      const ok = await ctx.ui.confirm("Dangerous!", "Allow rm -rf?");
      if (!ok) return { block: true, reason: "Blocked by user" };
    }
  });
}
Cette puissance a un revers, que la documentation souligne : extensions et paquets s'exécutent avec tous les droits du système, et une skill peut demander au modèle de lancer n'importe quel programme. Il faut relire le code d'un paquet tiers avant de l'installer. Au démarrage, pi demande d'ailleurs l'autorisation avant de charger les extensions et réglages propres à un dossier de projet.
Modèles, sessions et modes d'exécution
- Modèles : pi accepte des abonnements (ChatGPT Plus/Pro, GitHub Copilot, Claude Pro/Max, dont l'usage dans un harness tiers est facturé au token en usage supplémentaire selon la documentation de pi) et une trentaine de fournisseurs par clé d'API, dont OpenRouter, Mistral, Amazon Bedrock et Google Vertex. Tout serveur qui parle l'API d'OpenAI, d'Anthropic ou de Google se déclare dans
models.json: Ollama, LM Studio ou vLLM pour des modèles locaux. pi prend aussi en charge le routeur de llama.cpp, et Ollama le lance directement avecollama launch pi. - Sessions : chaque session est un fichier JSONL organisé en arbre.
/treepermet de revenir à n'importe quel point et d'en repartir,/forket/clonecréent de nouvelles sessions, et la compaction automatique résume l'historique ancien sans l'effacer du fichier./exportproduit un fichier HTML ou JSONL et/sharepublie la session dans un gist GitHub privé, avec un lien de partage. - Modes d'exécution : interactif, impression ou JSON (
pi -p,--mode json), RPC par l'entrée et la sortie standard, et SDK pour intégrer pi dans une application.
Notre tutoriel d'installation de pi le relie à un modèle open-weight par OpenRouter ou à Ollama, et montre comment l'isoler dans un conteneur.
Pourquoi JustAI utilise-t-il pi en ce moment ?
Chez JustAI, pi est en ce moment le harness que nous utilisons, avec des extensions internes. Nous l'avons retenu parce que nous observons une bien meilleure gestion du cache des tokens, et donc une bien meilleure optimisation. C'est une observation sur nos propres usages, pas un banc d'essai universel.
Le mécanisme en jeu est documenté. Les fournisseurs de modèles mettent en cache le début des requêtes, leur « préfixe » : chez Anthropic, les définitions d'outils, puis le prompt système, puis les messages. Toute modification de l'un de ces éléments invalide le cache pour ce qui suit. Or, sur la plupart des modèles Claude, un token relu depuis le cache est facturé 0,1 fois le prix d'un token d'entrée normal, quand l'écriture en cache (pour cinq minutes) coûte 1,25 fois ce prix. Dans une session d'agent, où chaque appel d'outil renvoie tout l'historique au modèle, la stabilité de ce préfixe pèse donc directement sur la facture.
pi est construit pour garder ce préfixe court et stable :
- à sa sortie, son auteur indiquait que le prompt système et les définitions d'outils de pi tenaient en moins de 1 000 tokens, et que seul le fichier
AGENTS.mdy était ajouté ; - quand une extension modifie des sections du prompt système, pi n'envoie qu'un message correctif pour les sections changées : les modèles qui acceptent un message système en cours de conversation conservent leur préfixe en cache (remplacer tout le prompt, en revanche, invalide le cache) ;
- les requêtes ponctuelles de compaction n'écrivent pas dans le cache, quand le fournisseur le permet ;
- le « cache warming » renvoie la dernière requête, avec un budget d'un seul token de sortie, juste avant l'expiration du cache, et seulement si l'économie nette attendue atteint 0,05 $ ; il vise par défaut l'API directe d'Anthropic, et d'autres modèles peuvent déclarer la durée de leur cache dans
models.json; - le pied de page affiche les tokens lus et écrits en cache et le dernier taux de succès, et
PI_CACHE_RETENTION=longallonge la durée du cache (une heure chez Anthropic, 24 heures chez OpenAI).
Ces mécanismes ne sont pas propres à pi. Claude Code affiche lui aussi des statistiques de cache et documente les actions qui l'invalident, parmi lesquelles le changement de modèle, la connexion d'un serveur MCP ou la mise à jour du harness ; Hermes documente, lui, sa stratégie de cache pour les modèles Claude et un moteur de compression du contexte remplaçable. La différence tient à la maîtrise : avec pi, l'équipe décide de ce qui entre dans le contexte, et ses extensions peuvent intervenir sur chaque requête. Le gain dépend du fournisseur, du modèle et de la façon de travailler ; mesurez-le sur vos propres sessions avant de généraliser.
Forces
- Un cœur court et lisible : quatre outils, un prompt système réduit et remplaçable (
SYSTEM.md), et un en-tête de démarrage qui liste ce qui est chargé dans le contexte (fichiersAGENTS.md, skills, extensions). - Un système d'extensions complet : outils, commandes, événements, interface et fournisseurs de modèles, empaquetés et partagés par npm ou git.
- Un cache visible et réglable : statistiques dans le pied de page, rétention longue, cache warming et hooks d'extension pour inspecter chaque requête envoyée au fournisseur.
- Des sessions arborescentes et une intégration facile : navigation, export et partage des sessions ; modes impression, JSON, RPC et SDK.
- Une chaîne d'approvisionnement surveillée : dépendances directes épinglées, installation sans scripts (
--ignore-scripts), dépendances transitives figées dans le paquet publié.
Limites
- Aucun système de permissions intégré : pi s'exécute avec les droits de l'utilisateur qui le lance. Pour des limites plus strictes, le projet documente trois isolations : conteneur Docker, micro-VM Gondolin ou sandbox OpenShell.
- Tout est à construire : sous-agents, mode plan, MCP, mémoire passent par une extension ou un paquet, qu'il faut ensuite maintenir. Cela suppose des compétences TypeScript dans l'équipe.
- Terminal uniquement : pas d'extension IDE, pas d'application de bureau, pas d'interface web. La messagerie passe par pi-chat, une extension distincte publiée par earendil-works (Discord et Telegram).
- Pas de gouvernance d'équipe : des réglages globaux et par projet, mais ni configuration gérée, ni SSO, ni console centrale.
- Un projet jeune et rapide : les versions se succèdent vite, et les tickets et pull requests des nouveaux contributeurs sont fermés automatiquement par défaut ; les mainteneurs relisent chaque jour les tickets ainsi fermés.
Claude Code vs OpenCode vs Hermes vs pi : le comparatif détaillé
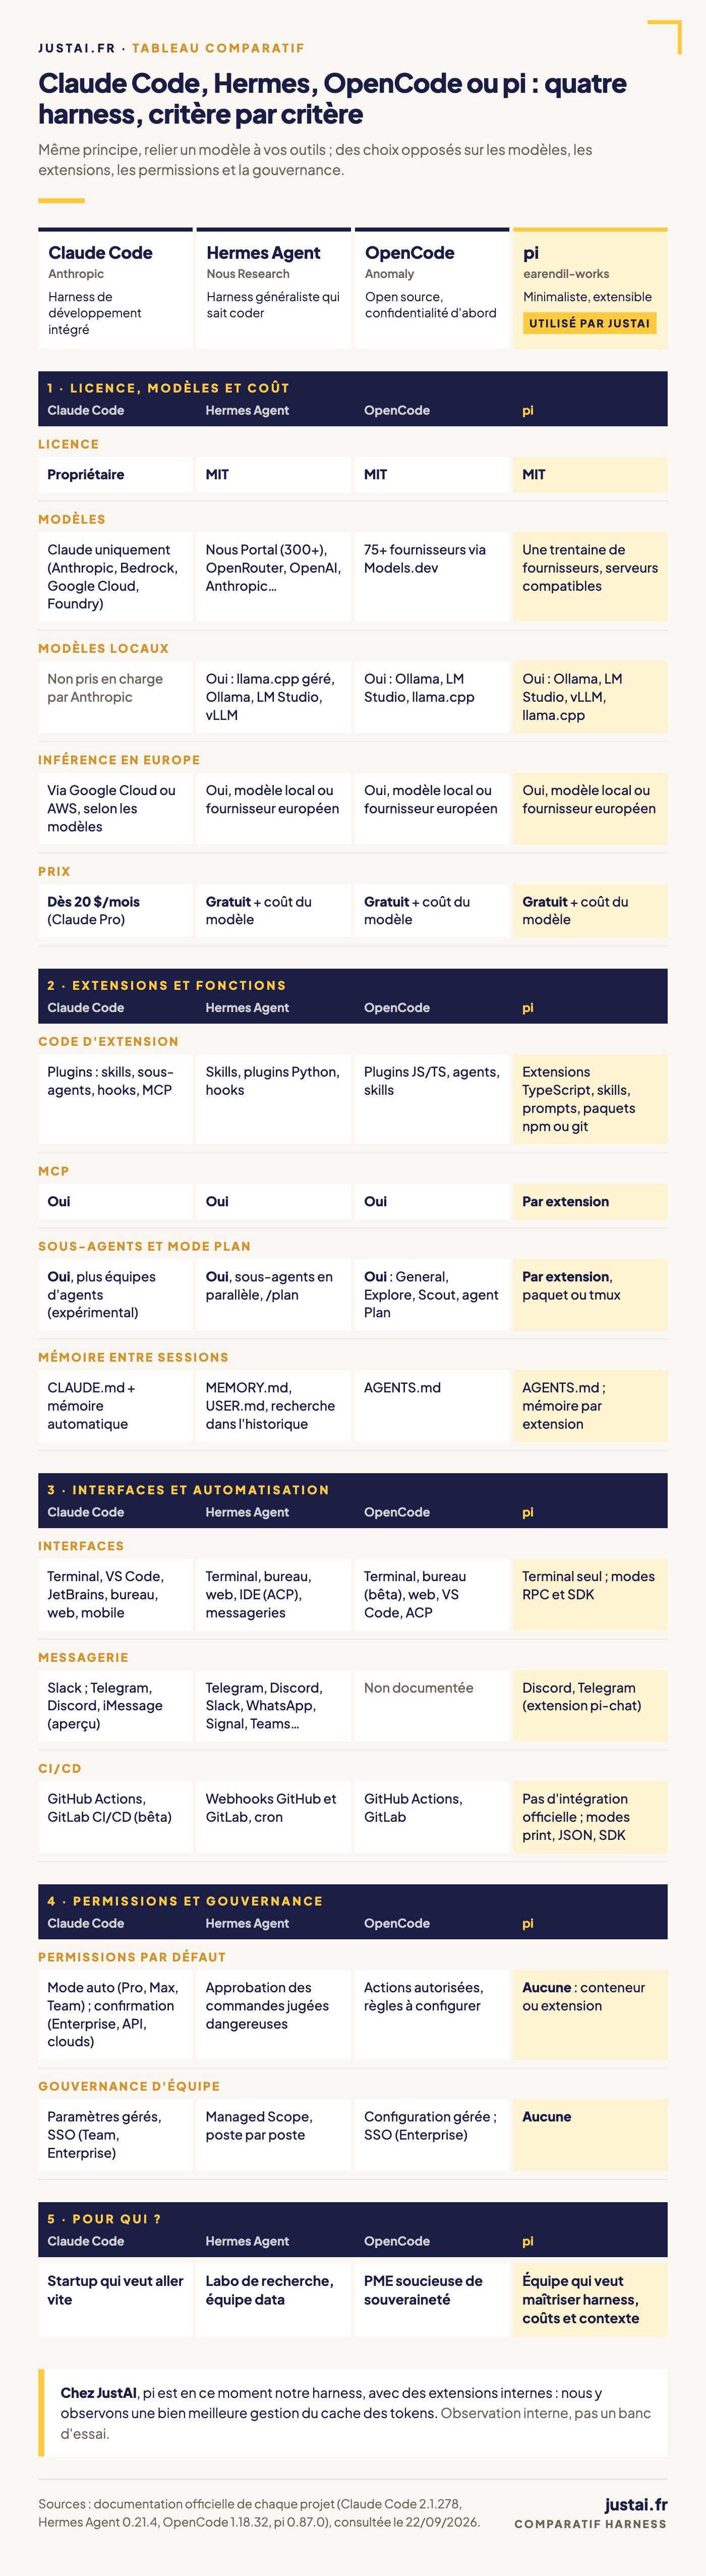
Modèles supportés et coût d'inférence
| Claude Code | Hermes Agent | OpenCode | pi | |
|---|---|---|---|---|
| Modèles hébergés | Claude uniquement (Anthropic, Bedrock, Google Cloud, Foundry) | Nous Portal, OpenRouter, OpenAI, Anthropic, Bedrock, Vertex AI… | 75+ fournisseurs, dont Claude, GPT, Gemini, Mistral | Une trentaine de fournisseurs, dont OpenRouter, Mistral, Bedrock, Vertex |
| Modèles locaux | Non pris en charge par Anthropic ; possible via l'API compatible d'Ollama | Oui : llama.cpp géré, Ollama, LM Studio, vLLM, SGLang | Oui : Ollama, LM Studio, llama.cpp | Oui : Ollama, LM Studio, vLLM, routeur llama.cpp |
| Abonnements utilisables | Claude Pro, Max, Team, Enterprise | Nous Portal, ChatGPT (Codex), GitHub Copilot, Claude Max (crédits d'usage supplémentaire uniquement) | GitHub Copilot, ChatGPT Plus/Pro, GitLab Duo, OpenCode Go | ChatGPT Plus/Pro, GitHub Copilot, Claude Pro/Max (facturé au token) |
| Coût d'entrée | 17 à 20 $/mois | ~0 $ (modèle local) ou VPS à 5 $/mois | ~0 $ (modèle local) | ~0 $ (modèle local) |
Pour une équipe qui veut un modèle local (Qwen, Mistral, Llama) pour des raisons de souveraineté ou de coût, Claude Code n'est pas conçu pour cela. Les trois autres le permettent, et Ollama propose un lanceur (ollama launch) pour chacun des quatre. Hermes va plus loin en gérant lui-même le moteur llama.cpp depuis son application de bureau. Reste la question de la puissance : la documentation d'Ollama recommande au moins 64 000 tokens de contexte pour les outils de code, ce qui demande une machine bien dotée en mémoire graphique.
Souveraineté et conformité RGPD
| Claude Code | Hermes Agent | OpenCode | pi | |
|---|---|---|---|---|
| Où partent le code et le contexte | Anthropic ou le cloud choisi | Le fournisseur du modèle ; nulle part avec un modèle local | Le fournisseur du modèle ; serveurs d'opencode.ai en cas de /share |
Le fournisseur du modèle ; gist GitHub privé en cas de /share |
| Conservation chez l'éditeur | 30 jours en offre commerciale, conservation nulle possible sur Enterprise ; Pro et Max : 30 jours, ou cinq ans si les données servent à améliorer les modèles | Aucune par le harness | Aucune (hors partage) | Aucune (signal anonyme d'installation désactivable) |
| Inférence en Europe | Possible via Google Cloud (eu) ou AWS, selon les modèles |
Oui (modèle local ou fournisseur européen) | Oui (modèle local ou fournisseur européen) | Oui (modèle local ou fournisseur européen) |
| Code source auditable | Non | Oui (MIT) | Oui (MIT) | Oui (MIT) |
C'est ici que le comparatif devient stratégique pour une entreprise française. Avec Claude Code, le code traité part chez Anthropic ou chez un fournisseur cloud, et tous sont des sociétés américaines, même quand l'inférence a lieu dans une région européenne. Avec les trois harness open source, la question se déplace vers l'hébergement du modèle : un modèle local ou hébergé en France garde le code sous contrôle, à condition de désactiver les fonctions de partage. Pour des données sensibles (santé, défense), l'arbitrage porte donc sur l'infrastructure qui sert le modèle, plus que sur le harness. Nous avons documenté cette mécanique dans notre analyse sur l'IA souveraine en France.
Expérience développeur
| Claude Code | Hermes Agent | OpenCode | pi | |
|---|---|---|---|---|
| Terminal (TUI) | Oui | Oui | Oui | Oui (seule interface officielle) |
| IDE | VS Code (et Cursor), JetBrains | VS Code, Zed, JetBrains (ACP) | VS Code et dérivés, éditeurs ACP | Non |
| Application de bureau | Oui (Linux en bêta) | Oui (Hermes Desktop) | Oui (bêta) | Non |
| Web | Oui (claude.ai/code) | Oui (hermes dashboard) |
Oui (opencode web, en local) |
Non (export HTML) |
| Messagerie | Slack ; Telegram, Discord, iMessage (channels, aperçu de recherche) | Telegram, Discord, Slack, WhatsApp, Signal, e-mail, Teams, Home Assistant… | Non documentée (bot Slack dans le dépôt) | Discord et Telegram via l'extension pi-chat |
| Mobile | Application Claude (iOS, Android) | Via la messagerie | Non | Via Termux (Android) ou pi-chat |
| Mode plan | Oui | Oui (/plan) |
Oui (agent Plan, touche Tab) | Par extension ou paquet |
| Mémoire entre sessions | CLAUDE.md + mémoire automatique | MEMORY.md et USER.md, recherche dans l'historique ; Honcho et autres en option |
AGENTS.md |
AGENTS.md ; mémoire par extension |
| Permissions par défaut | Mode auto (un classifieur vérifie chaque action) sur Pro, Max et Team ; confirmation avant modification ou commande sur Enterprise, API et clouds | Approbation des seules commandes jugées dangereuses | Actions autorisées, règles configurables | Aucune ; conteneur ou extension |
Extensions et personnalisation
| Claude Code | Hermes Agent | OpenCode | pi | |
|---|---|---|---|---|
| Instructions de projet | CLAUDE.md (AGENTS.md en l'absence de CLAUDE.md) | AGENTS.md, CLAUDE.md, SOUL.md… | AGENTS.md (CLAUDE.md en l'absence d'AGENTS.md) | AGENTS.md ou CLAUDE.md, prompt système remplaçable |
| Skills | Oui | Oui, créées et améliorées par l'agent | Oui | Oui (standard Agent Skills) |
| Code d'extension | Hooks et plugins | Plugins Python (outils, hooks, intégrations) | Plugins JavaScript/TypeScript | Extensions TypeScript (outils, commandes, événements, interface, fournisseurs) |
| MCP | Oui | Oui | Oui | Par extension |
| Distribution | Places de marché de plugins | Skills Hub, catalogue de plugins | Paquets npm | Paquets pi (npm ou git) |
Les quatre harness s'étendent, mais pas au même niveau. Claude Code, Hermes et OpenCode ajoutent des briques à un produit complet ; pi part d'un noyau minimal et laisse l'équipe décider de tout le reste. C'est ce qui le rend attractif pour qui veut maîtriser son outil, et exigeant pour qui veut simplement l'utiliser.
Automatisation et CI/CD
| Claude Code | Hermes Agent | OpenCode | pi | |
|---|---|---|---|---|
| GitHub | GitHub Actions (officiel) | Webhooks ou cron (guides officiels) | GitHub Actions (opencode github install) |
Pas d'intégration officielle |
| GitLab | GitLab CI/CD (bêta) | Webhooks (même adaptateur que pour GitHub) | GitLab CI (composant communautaire), GitLab Duo | Non documenté |
| Tâches planifiées | Routines (cloud, aperçu de recherche), tâches planifiées du bureau, /loop |
Cron intégré, livraison sur toutes les plateformes | Événement schedule du workflow GitHub |
Non intégré (cron système + mode impression) |
| Mode non interactif | claude -p |
hermes chat --oneshot -q, sortie JSON, traitement par lots |
opencode run, opencode serve |
pi -p, --mode json, --mode rpc, SDK |
| Sous-agents | Oui, plus équipes d'agents (expérimental) | Oui (sous-agents isolés, en parallèle) | Oui (General, Explore, Scout) | Par extension, ou instances lancées dans tmux |
Quel harness pour quel cas d'usage en entreprise ?
Pour une startup qui veut aller vite : Claude Code
Si l'équipe utilise déjà Claude et que la localisation des données n'est pas bloquante, Claude Code offre le meilleur ratio entre qualité et temps de prise en main. L'extension VS Code est transparente, la mémoire automatique évite de répéter le contexte, et GitHub Actions automatise les revues de pull requests sans effort supplémentaire. Encore faut-il que l'équipe sache cadrer, relire et sécuriser le travail d'un agent de code.
Pour une PME française soucieuse de souveraineté : OpenCode
OpenCode est le choix par défaut pour une PME qui veut garder le contrôle de ses données sans renoncer au confort d'un produit complet. La combinaison d'OpenCode et d'un modèle local ou hébergé en France (Mistral, Qwen) évite toute sortie du code vers un fournisseur extra-européen, à condition de désactiver le partage et de resserrer les permissions par défaut. Le fichier AGENTS.md porte les instructions du projet, et les sessions parallèles se gèrent sans infrastructure supplémentaire. C'est l'approche que nous recommandons en développement de logiciel sur mesure quand le code ne doit dépendre d'aucun fournisseur de modèle.
Pour un laboratoire de recherche ou une équipe data : Hermes Agent
Hermes est le seul des quatre à se présenter comme un instrument de recherche. La génération de trajectoires en lot, leur compression pour l'entraînement et la boucle d'auto-amélioration des skills en font un choix pertinent pour une équipe qui travaille sur l'agentique, le fine-tuning ou l'évaluation de modèles. Sa passerelle de messagerie, la plus large du comparatif, permet de piloter des expériences longues depuis un téléphone. À condition d'accepter que le développement logiciel n'est qu'un de ses usages, pas son cœur. Pour une équipe data qui hésite encore entre entraîner un modèle et brancher un RAG, les critères de choix entre fine-tuning et RAG aident à trancher.
Pour une équipe technique qui veut maîtriser son harness, ses coûts et son contexte : pi
pi convient à une équipe qui préfère construire son outil plutôt que de s'adapter à celui d'un éditeur : elle choisit ses modèles, contrôle ce qui entre dans le contexte, suit son cache requête par requête et ajoute exactement les fonctions dont elle a besoin par ses propres extensions. C'est notre cas : chez JustAI, pi est en ce moment notre harness, avec des extensions internes, en raison de la meilleure gestion du cache des tokens que nous observons. Les conditions de réussite sont claires : des compétences TypeScript pour écrire et maintenir les extensions, une isolation de l'agent (conteneur ou micro-VM) faute de permissions intégrées, et une revue systématique des paquets tiers.
Pour une DSI qui veut standardiser l'outillage : Claude Code et un harness open source en complément
Une approche pragmatique consiste à utiliser Claude Code pour le développement quotidien (qualité du code, CI/CD, administration centralisée) et un harness open source, comme OpenCode, pour les projets sensibles (code propriétaire, données clients, conformité RGPD). Elle évite de choisir entre intégration et souveraineté. Claude Code, OpenCode et Hermes permettent tous trois d'imposer une configuration que l'utilisateur ne peut pas contourner ; pi, non. Une stratégie IA qui précise quels projets utilisent quel harness, avec quels modèles, est ici le facteur de réussite.
Ce qui reste non résolu chez les quatre
La gouvernance en équipe progresse, mais inégalement. Claude Code va le plus loin : hooks, permissions par projet, paramètres gérés non contournables depuis un poste, SSO et, selon l'offre, plafonds de dépense fixés depuis la console d'administration. OpenCode propose une configuration gérée et, dans son offre Enterprise, une configuration centrale reliée au SSO. Hermes permet de figer des valeurs poste par poste. pi laisse tout à l'équipe. Aucun ne remplace une politique d'usage commune quand l'organisation combine plusieurs harness. Cette politique s'apprend en équipe, sur le dépôt réel : c'est l'objet de notre formation Claude Code pour les équipes de développement.
Le coût d'inférence à l'échelle reste un sujet de pilotage. Anthropic chiffre le coût moyen de Claude Code en entreprise à 150 à 250 $ par développeur et par mois ; pour une équipe de 20 développeurs, cela représente 36 000 à 60 000 $ par an. Le cache de prompt des fournisseurs est devenu un levier majeur, que les harness exposent et pilotent plus ou moins finement : c'est sur ce point que nous observons, pour notre part, l'avantage de pi. Le choix du modèle le moins cher selon la difficulté de la tâche, lui, reste surtout affaire de configuration (un modèle par agent ou par phase, comme le réglage opusplan de Claude Code, qui planifie avec Opus et exécute avec Sonnet) ou de routeurs externes, comme le routeur expérimental Pareto Code d'OpenRouter documenté par Hermes.
Enfin, la propriété intellectuelle du code généré n'est tranchée par aucun des quatre. OpenCode indique ne revendiquer aucun droit sur le code produit, mais les modèles entraînés sur du code sous licence (GPL, AGPL) peuvent reproduire des extraits protégés. L'entreprise reste responsable de la conformité du code qu'elle livre, pas l'éditeur du harness.
Conclusion : le harness n'est pas le choix, la stratégie l'est
Comparer Claude Code, Hermes Agent, OpenCode et pi sur des fonctionnalités donne une image partielle. Le vrai arbitrage est stratégique : quel niveau de dépendance fournisseur est acceptable ? Où votre code peut-il être traité ? Quel budget d'inférence êtes-vous prêt à absorber, et qui le pilote ?
Claude Code l'emporte sur l'intégration et l'administration, Hermes sur l'apprentissage et la polyvalence, OpenCode sur la souveraineté dans un produit complet, pi sur la maîtrise du contexte et du cache. Notre propre choix du moment, pi avec des extensions internes, illustre qu'un critère longtemps secondaire, la gestion du cache, peut devenir décisif. Mais aucun de ces harness ne résout à lui seul la question de leur déploiement dans une organisation de 50 ou 500 développeurs avec une gouvernance claire. C'est la question sur laquelle nous travaillons en mission, et la réponse dépend toujours du contexte.
Pour aller plus loin : notre rubrique tutoriels montre pas à pas comment installer OpenCode, installer Hermes Agent et installer pi, pour les essayer vous-même avant de trancher.
Lire aussi : Xirp : Spotify ouvre son orchestrateur d'agents de code et MCP (Model Context Protocol) : le standard qui transforme les agents IA d'entreprise
Sources
- Anthropic — Documentation Claude Code : coûts, utilisation des données, passerelles LLM et modes de permission (version 2.1.278, consultées le 22/09/2026)
- Anthropic — Prompt caching, documentation de l'API Claude et offres et tarifs Claude (consultées le 22/09/2026)
- Nous Research — Documentation Hermes Agent (version 0.21.4, consultée le 22/09/2026)
- Anomaly — Documentation OpenCode et page d'accueil opencode.ai (version 1.18.32, consultées le 22/09/2026)
- Earendil Works — pi coding agent : README, extensions et réglages, dont le cache warming (version 0.87.0, consultés le 22/09/2026)
- Mario Zechner — What I learned building an opinionated and minimal coding agent (30/11/2025)
- Ollama — Intégration de Claude Code et longueur de contexte (consultées le 22/09/2026)
- GitHub — API des dépôts NousResearch/hermes-agent, anomalyco/opencode et earendil-works/pi : étoiles et forks relevés le 22/09/2026
Vous hésitez entre un harness intégré et un harness que vous construisez vous-même ? Vous voulez savoir ce que le cache change à votre facture d'inférence ? Parlons-en : nous vous aidons à définir votre stratégie IA, à former vos équipes de développement et à mettre en production votre outil métier.