Ce qu'il faut retenir
- Le fine-tuning modifie la façon dont un modèle travaille, pas ce qu'il sait. Il apprend bien un format, un ton, une tâche répétitive ; il apprend mal des faits nouveaux, et ceux qu'il finit par apprendre augmentent sa tendance à halluciner (Gekhman et al., EMNLP 2024).
- Le RAG reste la réponse pour les connaissances qui changent et pour citer ses sources. Retirer ou mettre à jour un document dans un index est immédiat ; corriger ce qu'un modèle a appris suppose de le réentraîner.
- LoRA et QLoRA ont rendu l'entraînement accessible. LoRA peut diviser par 10 000 le nombre de paramètres entraînables et par 3 la mémoire GPU par rapport au fine-tuning complet de GPT-3 175B ; QLoRA permet de finetuner un modèle de 65 milliards de paramètres sur un seul GPU de 48 Go.
- Le calcul n'est plus le principal obstacle, la donnée et la maintenance le sont : des exemples validés par vos experts métier, un protocole d'évaluation, et un nouvel entraînement à chaque changement de modèle de base.
- Une API de fine-tuning propriétaire n'est pas un socle garanti. OpenAI a annoncé le 7 mai 2026 l'arrêt progressif de sa plateforme de fine-tuning en libre-service : ses clients actifs ne pourront plus lancer de nouvel entraînement à partir du 6 janvier 2027. Un modèle open-weight dont vous détenez les poids ne dépend pas de ce calendrier.
Fine-tuning d'un LLM : de quoi parle-t-on exactement ?
Le fine-tuning d'un LLM consiste à poursuivre l'entraînement d'un modèle de langage existant sur des exemples propres à votre entreprise, en modifiant ses poids. C'est la troisième option après le prompting et le RAG, et la plus souvent mal comprise : on l'imagine comme le moyen de « faire apprendre nos documents » au modèle, alors que c'est précisément ce qu'il fait le moins bien.
Les trois approches n'agissent pas au même endroit :
- Le prompting agit sur la consigne. On décrit la tâche, on ajoute quelques exemples dans la requête. Rien n'est modifié dans le modèle.
- Le RAG agit sur le contexte. Au moment de la question, un moteur de recherche fournit au modèle les passages pertinents de vos documents. L'article fondateur de Lewis et al. (2020) ajoute ainsi à la mémoire « paramétrique » du modèle une mémoire « non paramétrique », un index interrogeable, qui aide à indiquer la provenance d'une réponse et à mettre à jour les connaissances.
- Le fine-tuning agit sur le modèle lui-même. On lui présente des paires « entrée, sortie attendue » et on ajuste ses paramètres jusqu'à ce qu'il reproduise ce comportement sans consigne détaillée.
Le prompting, c'est la consigne laissée à un intérimaire ; le RAG, le classeur de procédures posé sur son bureau ; le fine-tuning, sa formation au métier. La formation change la manière de travailler. Elle ne remplace pas le classeur quand les procédures changent.
L'architecture d'un RAG est détaillée dans notre guide du RAG en entreprise. Cet article traite de la question suivante : quand faut-il aller plus loin et entraîner ?
Fine-tuning vs RAG : qu'est-ce que chacun change vraiment ?
Ce que le fine-tuning apprend mal : les faits
Gekhman et al. ont mesuré, dans un dispositif contrôlé de questions-réponses, ce qui se passe quand les exemples d'entraînement contiennent des faits que le modèle ignorait. Ces exemples sont appris nettement plus lentement que ceux qui concordent avec ce que le modèle sait déjà. Et à mesure qu'ils finissent par être appris, la tendance du modèle à halluciner augmente linéairement. Pour les auteurs, ces résultats confortent l'idée que les modèles acquièrent l'essentiel de leurs connaissances factuelles au pré-entraînement, et que le fine-tuning leur apprend surtout à s'en servir plus efficacement.
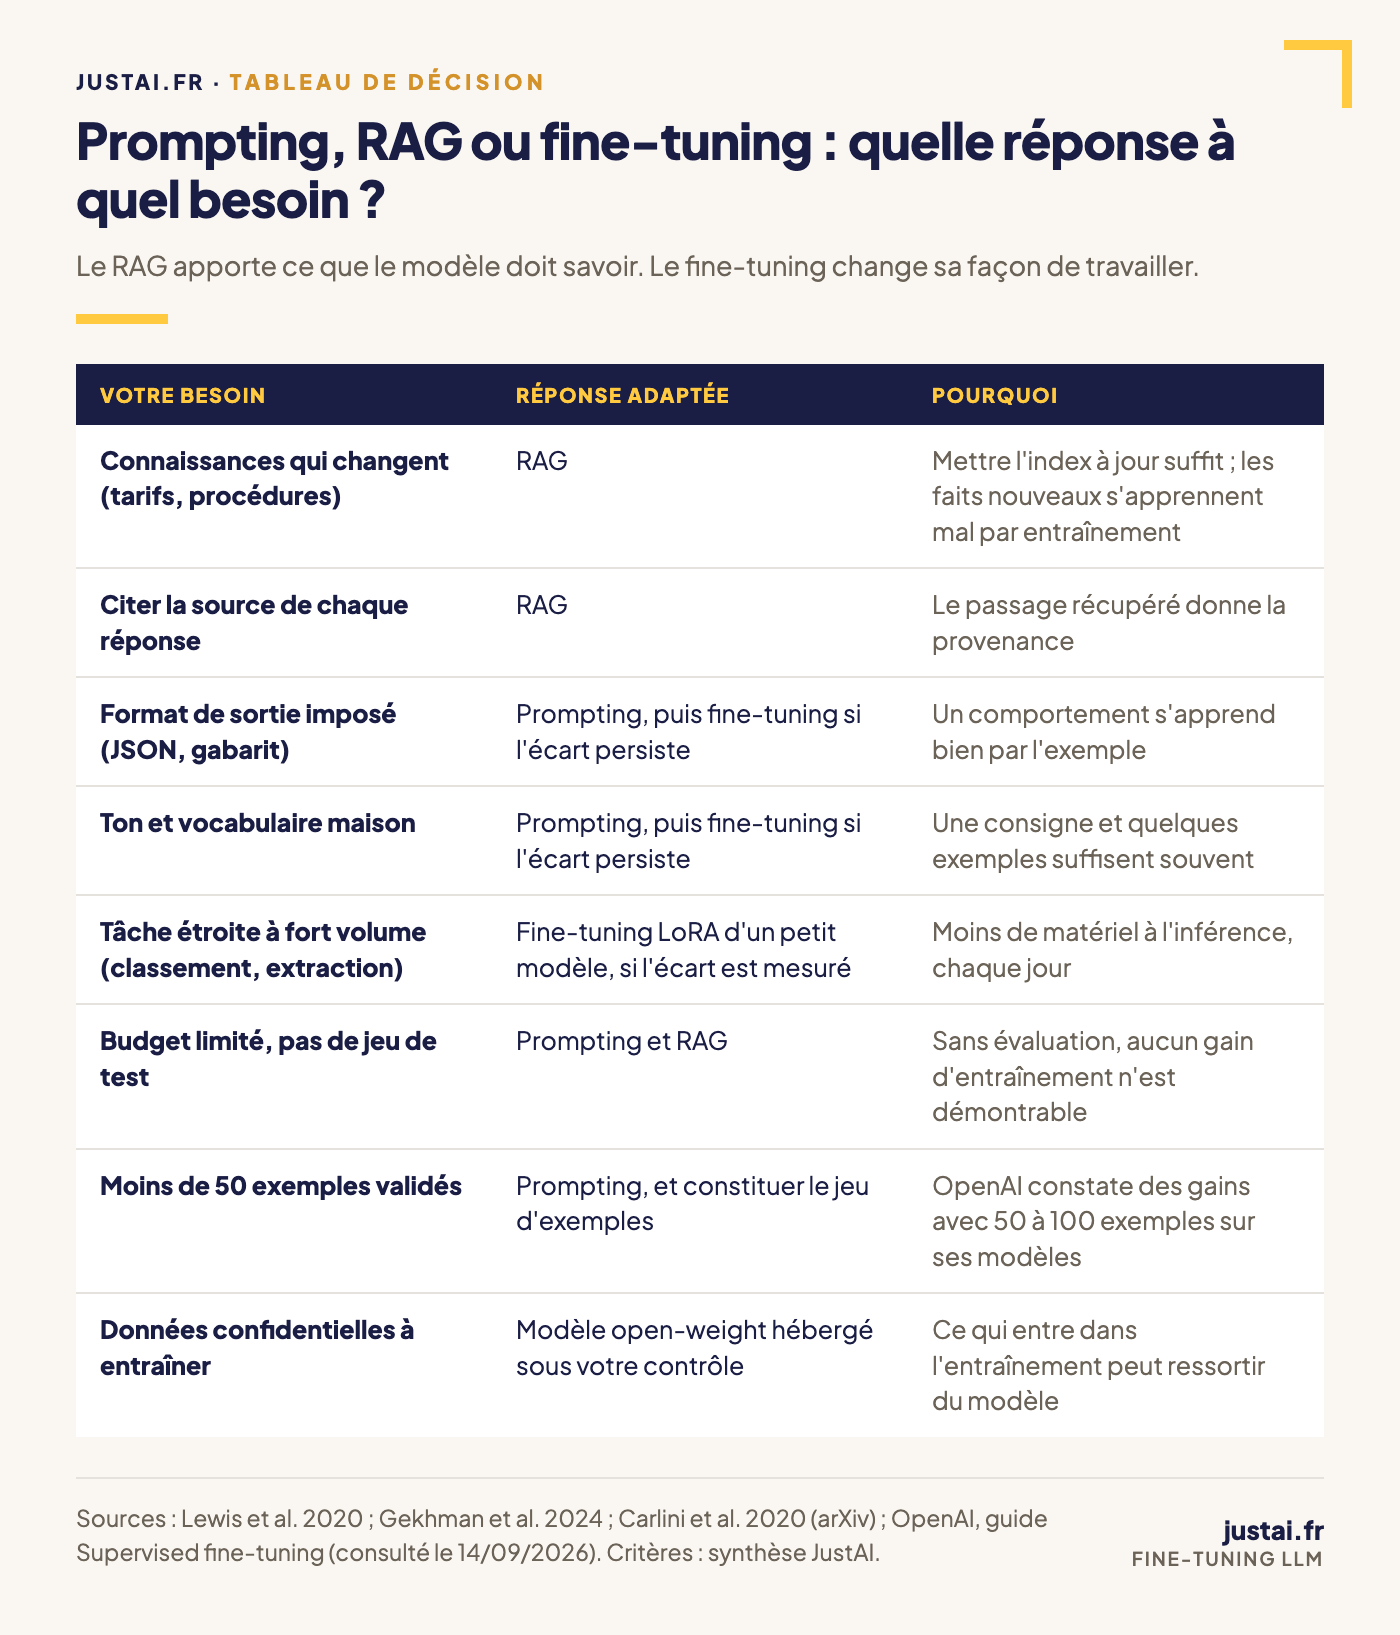
Traduit en termes d'entreprise : entraîner un modèle sur votre catalogue tarifaire ou vos procédures qualité ne produit pas un expert fiable de ces documents, mais au mieux un modèle qui en parle avec assurance, sans pouvoir dire d'où il tient sa réponse, et qu'il faudra réentraîner à la prochaine révision. Pour ce besoin, le RAG est plus sûr.
Ce que le fine-tuning apprend bien : le comportement
Tout ce qui relève de la forme et de la répétition est en revanche un bon terrain :
- Un format de sortie strict : un JSON conforme à un schéma, un gabarit de compte rendu, une nomenclature interne.
- Un ton et un vocabulaire imposés : la manière de répondre de votre service client, les formulations proscrites.
- Une tâche étroite répétée à grand volume : orienter un courrier entrant, affecter une ligne de facture à un compte comptable, extraire les mêmes champs de documents d'un même type.
La documentation d'OpenAI sur le fine-tuning supervisé cite des cas du même ordre : classification, traduction nuancée, génération dans un format précis, correction des défauts de suivi d'instructions.
Le prompting passe avant les deux
Un modèle récent suit souvent un format ou un ton à partir d'une consigne claire et de quelques exemples. La même documentation pose une règle de méthode que nous faisons nôtre : des évaluations d'abord, et le fine-tuning seulement ensuite. Sans jeu de test, impossible de savoir si l'entraînement fait mieux que la consigne. Le même principe vaut pour former une équipe de développement à cadrer et tester un agent de code.
Les approches ne s'excluent pas : un modèle entraîné à produire le bon format peut s'appuyer sur un RAG pour les faits.
Quand le fine-tuning d'un LLM est-il le bon choix ?
Quatre questions tranchent la plupart des cas.
- Le besoin porte-t-il sur ce que le modèle sait, ou sur sa façon de travailler ? Ce qu'il sait relève du RAG. Sa façon de travailler relève du prompting, puis du fine-tuning si la consigne ne suffit pas.
- L'écart est-il mesuré ? Si le modèle, avec une bonne consigne et le bon contexte, atteint déjà le niveau exigé sur votre jeu de test, entraîner n'apporte rien.
- La tâche est-elle répétée à grand volume ? C'est là que l'entraînement se rentabilise : un petit modèle spécialisé, qui n'a plus besoin d'une longue consigne à chaque appel, se sert sur moins de matériel qu'un grand modèle généraliste.
- Disposez-vous d'exemples validés ? Pas de documents bruts, mais des paires entrée-sortie corrigées par quelqu'un qui connaît le métier.
LoRA, QLoRA, fine-tuning complet : quelles méthodes pour entraîner un modèle sur mesure ?
Le fine-tuning complet
Il réentraîne tous les paramètres : c'est l'approche la plus expressive et la plus lourde, puisque chaque version entraînée est une copie intégrale du modèle. Pour GPT-3 175B, les auteurs de LoRA jugent ce déploiement d'un coût prohibitif.
LoRA : entraîner un adaptateur plutôt que le modèle
LoRA (Low-Rank Adaptation, Hu et al., 2021) gèle les poids du modèle d'origine et injecte dans chaque couche de petites matrices entraînables. Par rapport à GPT-3 175B finetuné avec l'optimiseur Adam, la méthode peut diviser par 10 000 le nombre de paramètres entraînables et par 3 la mémoire GPU, avec une qualité équivalente ou supérieure sur les modèles testés.
La documentation de la bibliothèque PEFT de Hugging Face en tire deux usages. L'adaptateur peut être fusionné dans le modèle de base pour supprimer la latence due à son chargement séparé. Ou plusieurs adaptateurs peuvent être chargés sur un même modèle de base et activés à la demande : un modèle, plusieurs spécialisations métier.
LoRA a un prix. Biderman et al. (2024) montrent que, dans ses configurations courantes, il fait nettement moins bien que le fine-tuning complet en programmation et en mathématiques, mais préserve mieux les performances hors du domaine visé. Leur titre résume l'arbitrage : LoRA apprend moins et oublie moins. Pour une tâche étroite où l'on veut surtout ne rien dégrader d'autre, ce compromis est souvent le bon.
QLoRA : entraîner sur un modèle compressé
QLoRA (Dettmers et al., 2023) combine LoRA et quantification : le modèle de base est figé sur 4 bits, seuls les adaptateurs sont entraînés. Les auteurs finetunent ainsi un modèle de 65 milliards de paramètres sur un seul GPU de 48 Go, en conservant les performances d'un fine-tuning en 16 bits ; leurs meilleurs modèles ont demandé 24 heures d'entraînement sur un seul GPU. Le principe de la quantification est expliqué dans notre article sur TurboQuant.
La mise en œuvre est devenue standard : l'entraîneur supervisé de la bibliothèque TRL de Hugging Face accepte des paires « prompt, réponse » et intègre LoRA comme QLoRA par configuration. La difficulté est désormais dans ce qu'on donne à apprendre et dans la vérification du résultat.
Données, GPU, évaluation : combien coûte un fine-tuning ?
Il n'existe pas de prix type : le coût dépend de la taille du modèle, du volume d'exemples, du nombre d'itérations et de l'infrastructure. Les postes, eux, sont constants.
Les données : le vrai chantier
OpenAI indique un minimum de 10 exemples, constate des améliorations avec 50 à 100 exemples tout en précisant que le bon volume varie fortement selon les cas, et recommande de commencer par 50 exemples soignés avant d'évaluer. Ces ordres de grandeur valent pour ses modèles ; ils ne se transposent pas tels quels à tous les modèles open-weight.
Le coût réel est l'annotation : la sortie attendue de chaque exemple doit être rédigée par un expert métier, car des annotations incohérentes apprennent l'incohérence. Chaque exemple doit aussi être débarrassé des données confidentielles inutiles, pour une raison exposée plus bas.
Le calcul : court à l'entraînement, continu à l'inférence
Avec LoRA ou QLoRA, un entraînement peut se compter en heures de GPU. Le poste qui dure est l'inférence, chaque jour, pour chaque document : c'est sur la durée d'exploitation que se mesure le gain d'un petit modèle spécialisé.
L'évaluation : avant, pendant, après
- Un jeu de test tenu à l'écart de l'entraînement, construit avec le métier.
- Une référence : le score du prompting seul, puis avec RAG. Le fine-tuning doit battre cette référence.
- Des tests de non-régression sur ce que le modèle savait faire avant.
- La même batterie rejouée à chaque nouvelle version du modèle ou des données.
Quels risques : oubli catastrophique, fuite de données, maintenance
L'oubli catastrophique
Entraîner un modèle sur une tâche peut dégrader ses capacités générales. Les travaux de Biderman et al. confirment que LoRA atténue cet oubli sans l'annuler : les tests de non-régression restent indispensables.
La fuite des données d'entraînement
Carlini et al. ont extrait de GPT-2, simplement en l'interrogeant, des centaines de séquences recopiées mot pour mot de ses données d'entraînement : noms, numéros de téléphone et adresses e-mail publics, conversations, code. L'attaque fonctionnait même pour des séquences présentes dans un seul document du corpus.
Pour une entreprise, la conséquence est directe : ce qui entre dans le jeu d'entraînement peut ressortir du modèle, et des poids entraînés sur des données confidentielles sont aussi confidentiels qu'elles. Un RAG offre une prise que le fine-tuning n'offre pas : les droits d'accès s'appliquent document par document, et un document retiré de l'index cesse aussitôt d'être utilisé.
La maintenance à chaque nouveau modèle
Un adaptateur est entraîné pour un modèle de base donné : changer de modèle, c'est réentraîner et réévaluer. Sur une API propriétaire, ce calendrier ne vous appartient pas. OpenAI indique que les modèles finetunés sur sa plateforme restent disponibles jusqu'à la dépréciation de leur modèle de base, et que ses clients actifs ne pourront plus créer d'entraînement à partir du 6 janvier 2027. Un modèle open-weight dont vous détenez les poids reste en service aussi longtemps que vous le décidez.
Quel impact concret pour une PME ou une ETI ?
La décision porte rarement sur « fine-tuning ou pas », mais sur l'ordre. Un projet commence par une consigne bien construite et un RAG sur un corpus maîtrisé ; le fine-tuning vient ensuite, sur une tâche répétitive précise, quand un écart est mesuré. Choisir les cas d'usage qui justifient cet effort est un travail de cadrage : c'est l'objet de notre diagnostic data et IA, dont la grille de maturité en 5 axes et 20 critères aboutit à un portefeuille de cas d'usage priorisé et à une feuille de route chiffrée.
Reste la maîtrise des données et des poids. Quand la tâche est propre à votre métier, les données d'entraînement sont souvent sensibles, et les poids qui en résultent le sont aussi. C'est pourquoi nous déployons des modèles open-weight que nous finetunons et alignons sur les règles du client, et que nous servons par nos propres API depuis nos serveurs GPU en colocation en France chez un acteur français : dans ces déploiements, aucune requête ne part vers ChatGPT, Claude ou Gemini. Les API américaines gardent leur place pour des usages sans enjeu de confidentialité. Pour les autres, un hébergement en France par un fournisseur soumis au droit américain ne suffit pas, en raison de la portée extraterritoriale du Cloud Act. Notre approche est détaillée sur la page IA souveraine, et le contexte du marché dans notre analyse Mistral, cloud souverain et alternatives.
L'alignement, ce que le modèle accepte, refuse et priorise, relève du même travail. Notre article de recherche Statutory AI, présenté à la conférence AIDT 2026, propose de gouverner le comportement d'un modèle à partir d'articles de loi explicites, publics et vérifiables plutôt que d'une constitution rédigée à la main.
Les limites de ce raisonnement
Les résultats cités viennent de cadres précis (questions-réponses sans documents, programmation et mathématiques, GPT-2) : leur direction est solide, leurs ordres de grandeur ne se transposent pas directement à votre cas.
L'écosystème évolue vite : les calendriers des éditeurs changent, et une tâche qui exige un fine-tuning avec une génération de modèles peut ne plus l'exiger avec la suivante. D'autres méthodes, comme l'alignement par préférences ou la distillation, ne sont pas traitées ici. Enfin, aucun entraînement ne corrige un processus mal défini ou des exemples contradictoires : il les reproduit fidèlement.
Conclusion : entraîner pour le comportement, brancher pour la connaissance
La règle tient en une phrase : le RAG apporte au modèle ce qu'il doit savoir, le fine-tuning change la façon dont il travaille. Le premier sert les connaissances qui bougent et la traçabilité ; le second sert les formats, le ton et les tâches répétitives à fort volume, là où un petit modèle spécialisé peut devenir plus économique qu'un grand généraliste.
LoRA et QLoRA ont fait tomber la barrière du calcul. Restent deux exigences qui ne se délèguent pas : des exemples validés par le métier et une évaluation rejouée à chaque version. Sans elles, mieux vaut commencer par une bonne consigne et un RAG propre.
Lire aussi : RAG entreprise : comment construire une base de connaissances IA qui marche vraiment
Sources
- arXiv — Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (22 mai 2020, révisé le 12 avril 2021)
- arXiv — Hu et al., LoRA: Low-Rank Adaptation of Large Language Models (17 juin 2021, révisé le 16 octobre 2021)
- arXiv — Dettmers et al., QLoRA: Efficient Finetuning of Quantized LLMs (23 mai 2023)
- arXiv — Gekhman et al., Does Fine-Tuning LLMs on New Knowledge Encourage Hallucinations? (9 mai 2024, révisé le 1er octobre 2024, EMNLP 2024)
- arXiv — Biderman et al., LoRA Learns Less and Forgets Less (15 mai 2024, révisé le 20 septembre 2024)
- arXiv — Carlini et al., Extracting Training Data from Large Language Models (14 décembre 2020, révisé le 15 juin 2021)
- Hugging Face — documentation PEFT, guide LoRA et documentation TRL, SFT Trainer (consultées le 14 septembre 2026)
- OpenAI — Deprecations, « Update to OpenAI's self-serve fine-tuning » (annonce du 7 mai 2026) et guide Supervised fine-tuning (consulté le 14 septembre 2026)
Vous hésitez entre entraîner un modèle et brancher vos documents ? Vous avez une tâche répétitive à fort volume et des données que vous ne voulez pas confier à une API tierce ? Parlons-en — nous vous aidons à choisir les cas d'usage qui justifient un entraînement et à déployer un modèle open-weight finetuné sur une infrastructure souveraine.