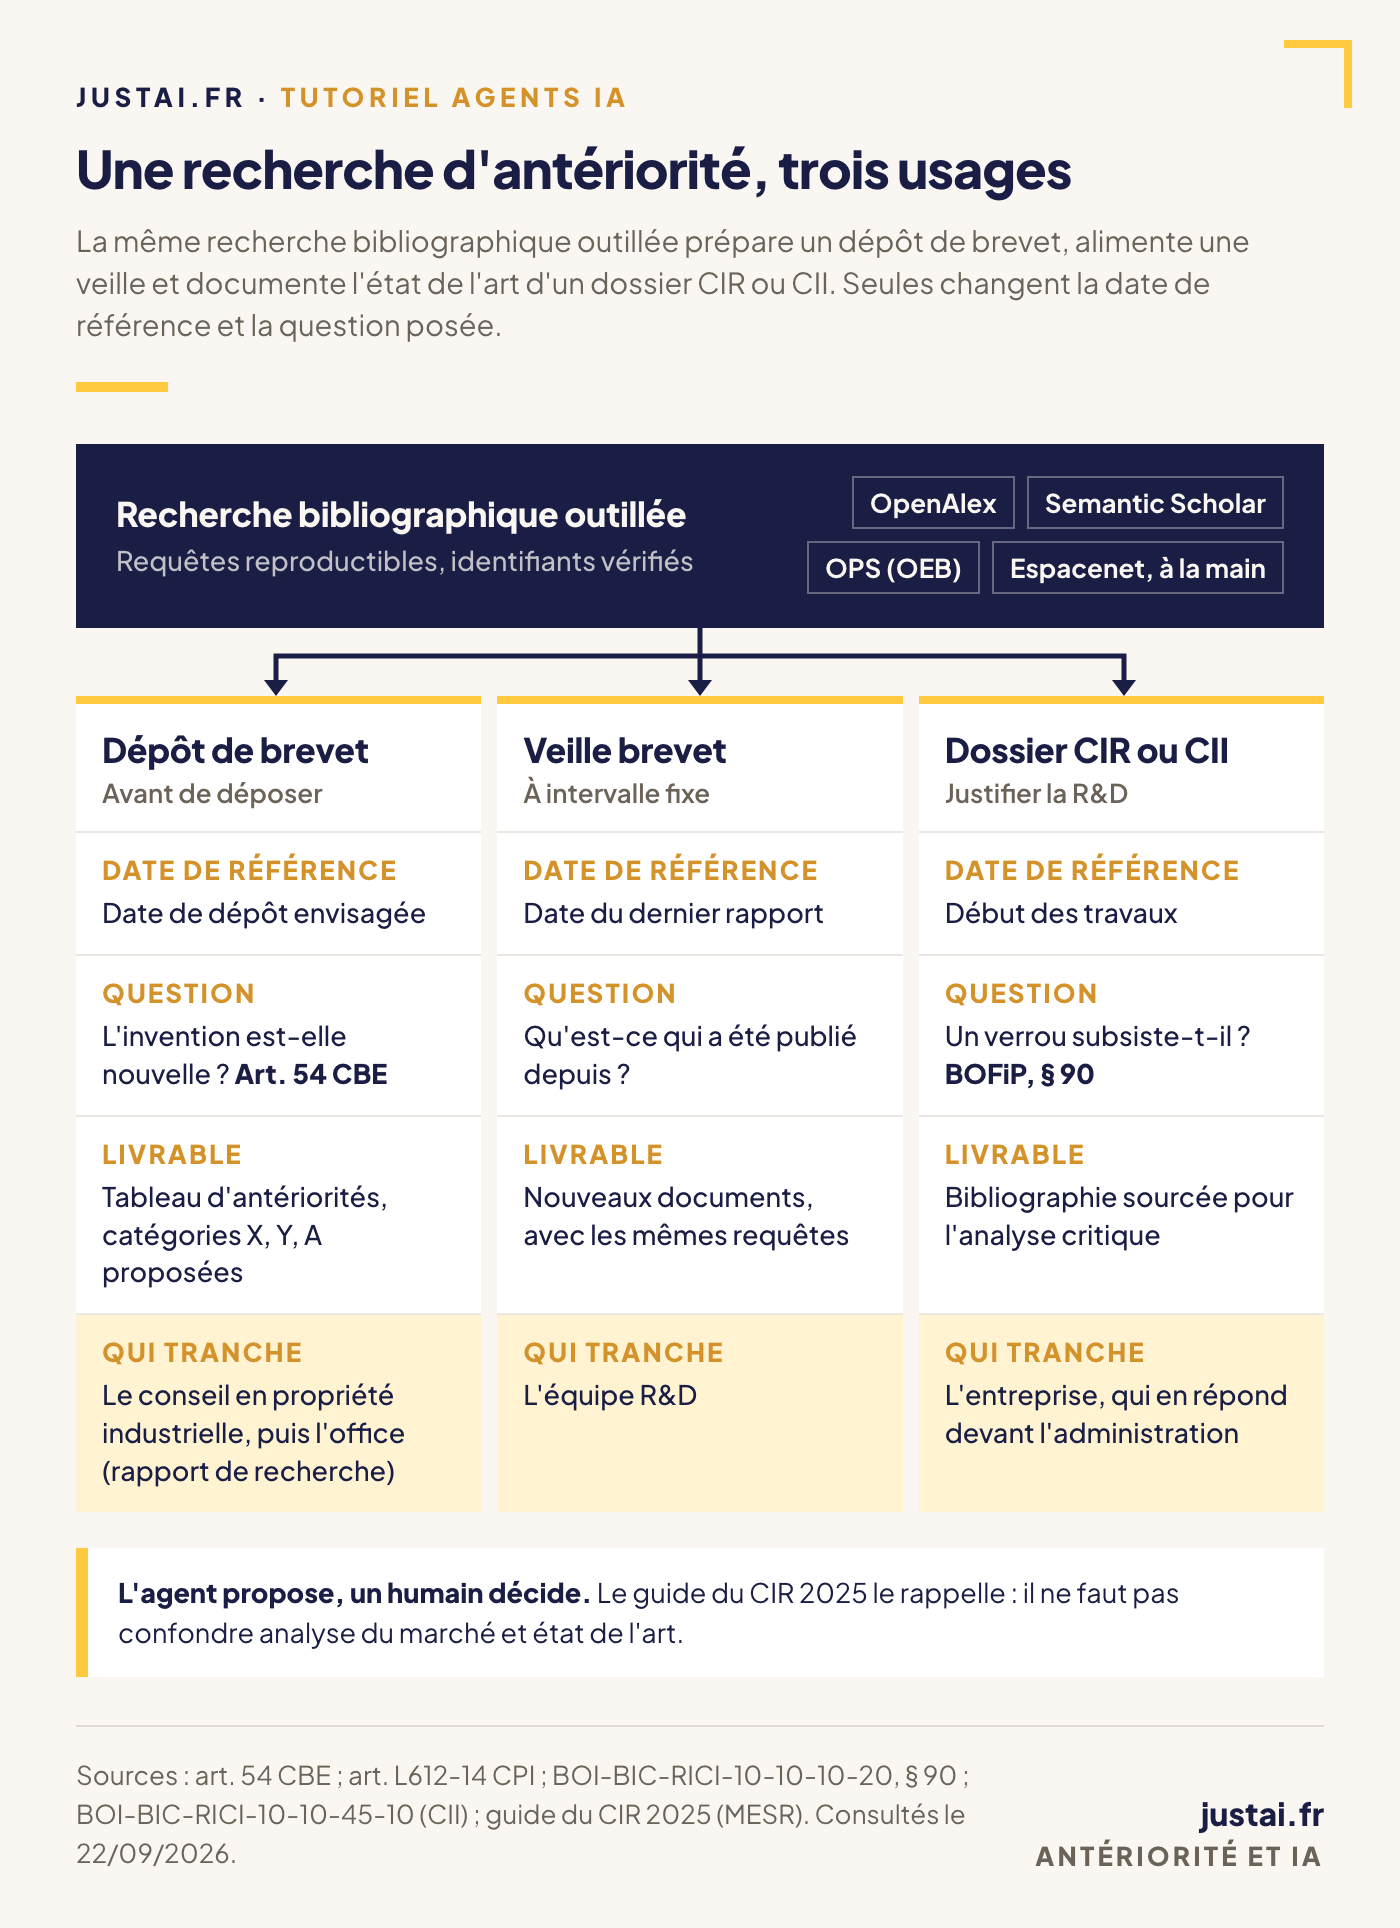
À la fin de ce tutoriel, cinq agents OpenCode (un orchestrateur et quatre sous-agents) interrogent OpenAlex, Semantic Scholar et les données brevets de l'Office européen des brevets (OEB), comparent chaque document à votre invention et rédigent un rapport sourcé : stratégie de recherche, tableau d'antériorités à identifiants vérifiés, écarts et limites. Cette recherche bibliographique sert trois usages : préparer un dépôt de brevet avec votre conseil en propriété industrielle, tenir une veille brevet, rédiger l'état de l'art d'un dossier de crédit d'impôt recherche (CIR) ou innovation (CII).
L'équipe balaie, trie et source. Elle ne rend pas d'avis de brevetabilité, ne fait pas d'étude de liberté d'exploitation et ne remplace ni votre conseil ni le rapport de recherche de l'office. Le tutoriel s'adresse aux responsables R&D, ingénieurs et chargés de propriété industrielle à l'aise avec un terminal.
Ce qui a été exécuté. Le 22 septembre 2026, nous avons lancé litterature.py contre l'API OpenAlex, ainsi que contre Semantic Scholar : les sorties reproduites sont réelles. Sans clé, Semantic Scholar a refusé nos requêtes (« 429 Too Many Requests ») pendant près d'un quart d'heure, puis a répondu. Faute de compte OPS validé, brevets.py suit le guide de référence d'OPS (version 1.3.20) et n'a été testé que sur des réponses construites d'après ses exemples ; ses réactions aux identifiants et aux jetons invalides ont été vérifiées sur le service réel. La configuration OpenCode suit la documentation de la version 1.18.32 : nous avons contrôlé opencode.json et le frontmatter des agents avec le schéma JSON officiel d'OpenCode (seul le nom du modèle local, absent du catalogue models.dev, y est signalé), sans lancer l'outil.
Prérequis
- OpenCode installé : voir Installer OpenCode en local. La section « Transposer à pi » adapte le montage au harness pi.
- Python 3 : les scripts n'utilisent que la bibliothèque standard (testés avec Python 3.12).
- Les accès aux sources, décrits à la section 3. Inscrivez-vous à OPS en premier : l'OEB valide chaque compte avant de l'activer.
- Un modèle local pour une invention non déposée : Ollama et Qwen3.6 35B A3B, comme dans la section 3 du tutoriel OpenCode (environ 24 Go de mémoire vidéo selon la documentation d'Ollama).
1. Ce qu'il faut savoir avant de brancher un agent
Antériorité et confidentialité
Selon l'article 54 de la Convention sur le brevet européen (CBE), repris par l'article L611-11 du code de la propriété intellectuelle (CPI), une invention est nouvelle si elle n'est pas comprise dans l'état de la technique : tout ce qui a été rendu accessible au public avant la date de dépôt, par écrit, oralement, par un usage ou tout autre moyen. Les Directives de l'OEB (G-IV, 1) n'y mettent de limite ni de lieu, ni de langue, ni d'ancienneté : une recherche limitée aux articles en anglais laisse des trous.
Un document est accessible au public si des membres du public pouvaient en prendre connaissance et si aucune obligation de confidentialité n'en limitait l'usage. Et il n'existe pas de délai de grâce général : l'article 55 CBE et l'article L611-13 CPI n'écartent une divulgation que si elle date de moins de six mois et résulte d'un abus évident ou d'une exposition officielle. La description d'une invention non déposée ne doit donc pas partir chez un service en ligne quelconque : le montage qui suit est conçu pour la garder sur votre poste, à condition de la confier à un modèle local.
Ce qu'un agent fait bien, et ce qu'il ne fait pas
Un agent formule des dizaines de requêtes, lit des centaines de notices, élimine les doublons et note la source de chaque document. Il ne décide pas :
- de la nouveauté ou de l'activité inventive. Il propose une catégorie, selon le code des rapports de recherche de l'OEB (Directives B-X, 9.2) : X, un document qui, à lui seul, met en cause la nouveauté ou l'activité inventive ; Y, un document qui met en cause l'activité inventive combiné à d'autres ; A, un document de l'état de la technique qui ne détruit ni la nouveauté ni l'activité inventive. Votre conseil valide ;
- de la liberté d'exploitation. Elle porte sur les revendications en vigueur et le statut juridique pays par pays, que seul un professionnel interprète ;
- à la place du conseil en propriété industrielle, dont le titre est protégé (article L422-1 CPI). Une demande de brevet français donne d'ailleurs lieu, en principe, à un rapport de recherche sur l'état de la technique (article L612-14 CPI). Le rapport des agents prépare ce travail.
Enfin, une machine n'est pas inventeur au sens de la CBE : c'est l'exergue des décisions J 8/20 et J 9/20 (chambre de recours juridique, 21 décembre 2021, affaire DABUS). La chambre ajoute (point 4.6.6) ne connaître aucune jurisprudence qui empêcherait l'utilisateur d'un tel outil de se désigner lui-même comme inventeur. Les agents assistent ; les inventeurs restent des personnes.
Pour un dossier CIR ou CII
Le BOFiP (BOI-BIC-RICI-10-10-10-20, § 90) fait de l'état de l'art la référence pour qualifier une opération de R&D : une recherche bibliographique (articles, actes de conférences, thèses, brevets, bases techniques) et une analyse détaillée des approches existantes, au regard des connaissances accessibles au début des travaux. Si une solution accessible contourne le verrou, c'est de l'ingénierie, non éligible. Le guide du CIR 2025, dépourvu de valeur réglementaire selon ses auteurs, demande de justifier le verrou par une « analyse critique de l'état de l'art », limite la fiche à 10 pages par opération et avertit : il ne faut pas confondre analyse du marché et état de l'art. Les dépenses de veille technologique n'y sont éligibles que si elles ont été exposées avant le 15 février 2025.
Pour le CII, réservé aux PME, le BOFiP (BOI-BIC-RICI-10-10-45-10) mesure la nouveauté par rapport au marché, constitué de l'entreprise et de ses concurrentes (§ 100), et cite les brevets parmi les documents qui permettent de qualifier les performances du produit (§ 130). L'agent couvre la partie brevets ; l'analyse des offres concurrentes reste à faire.
2. L'architecture de l'équipe
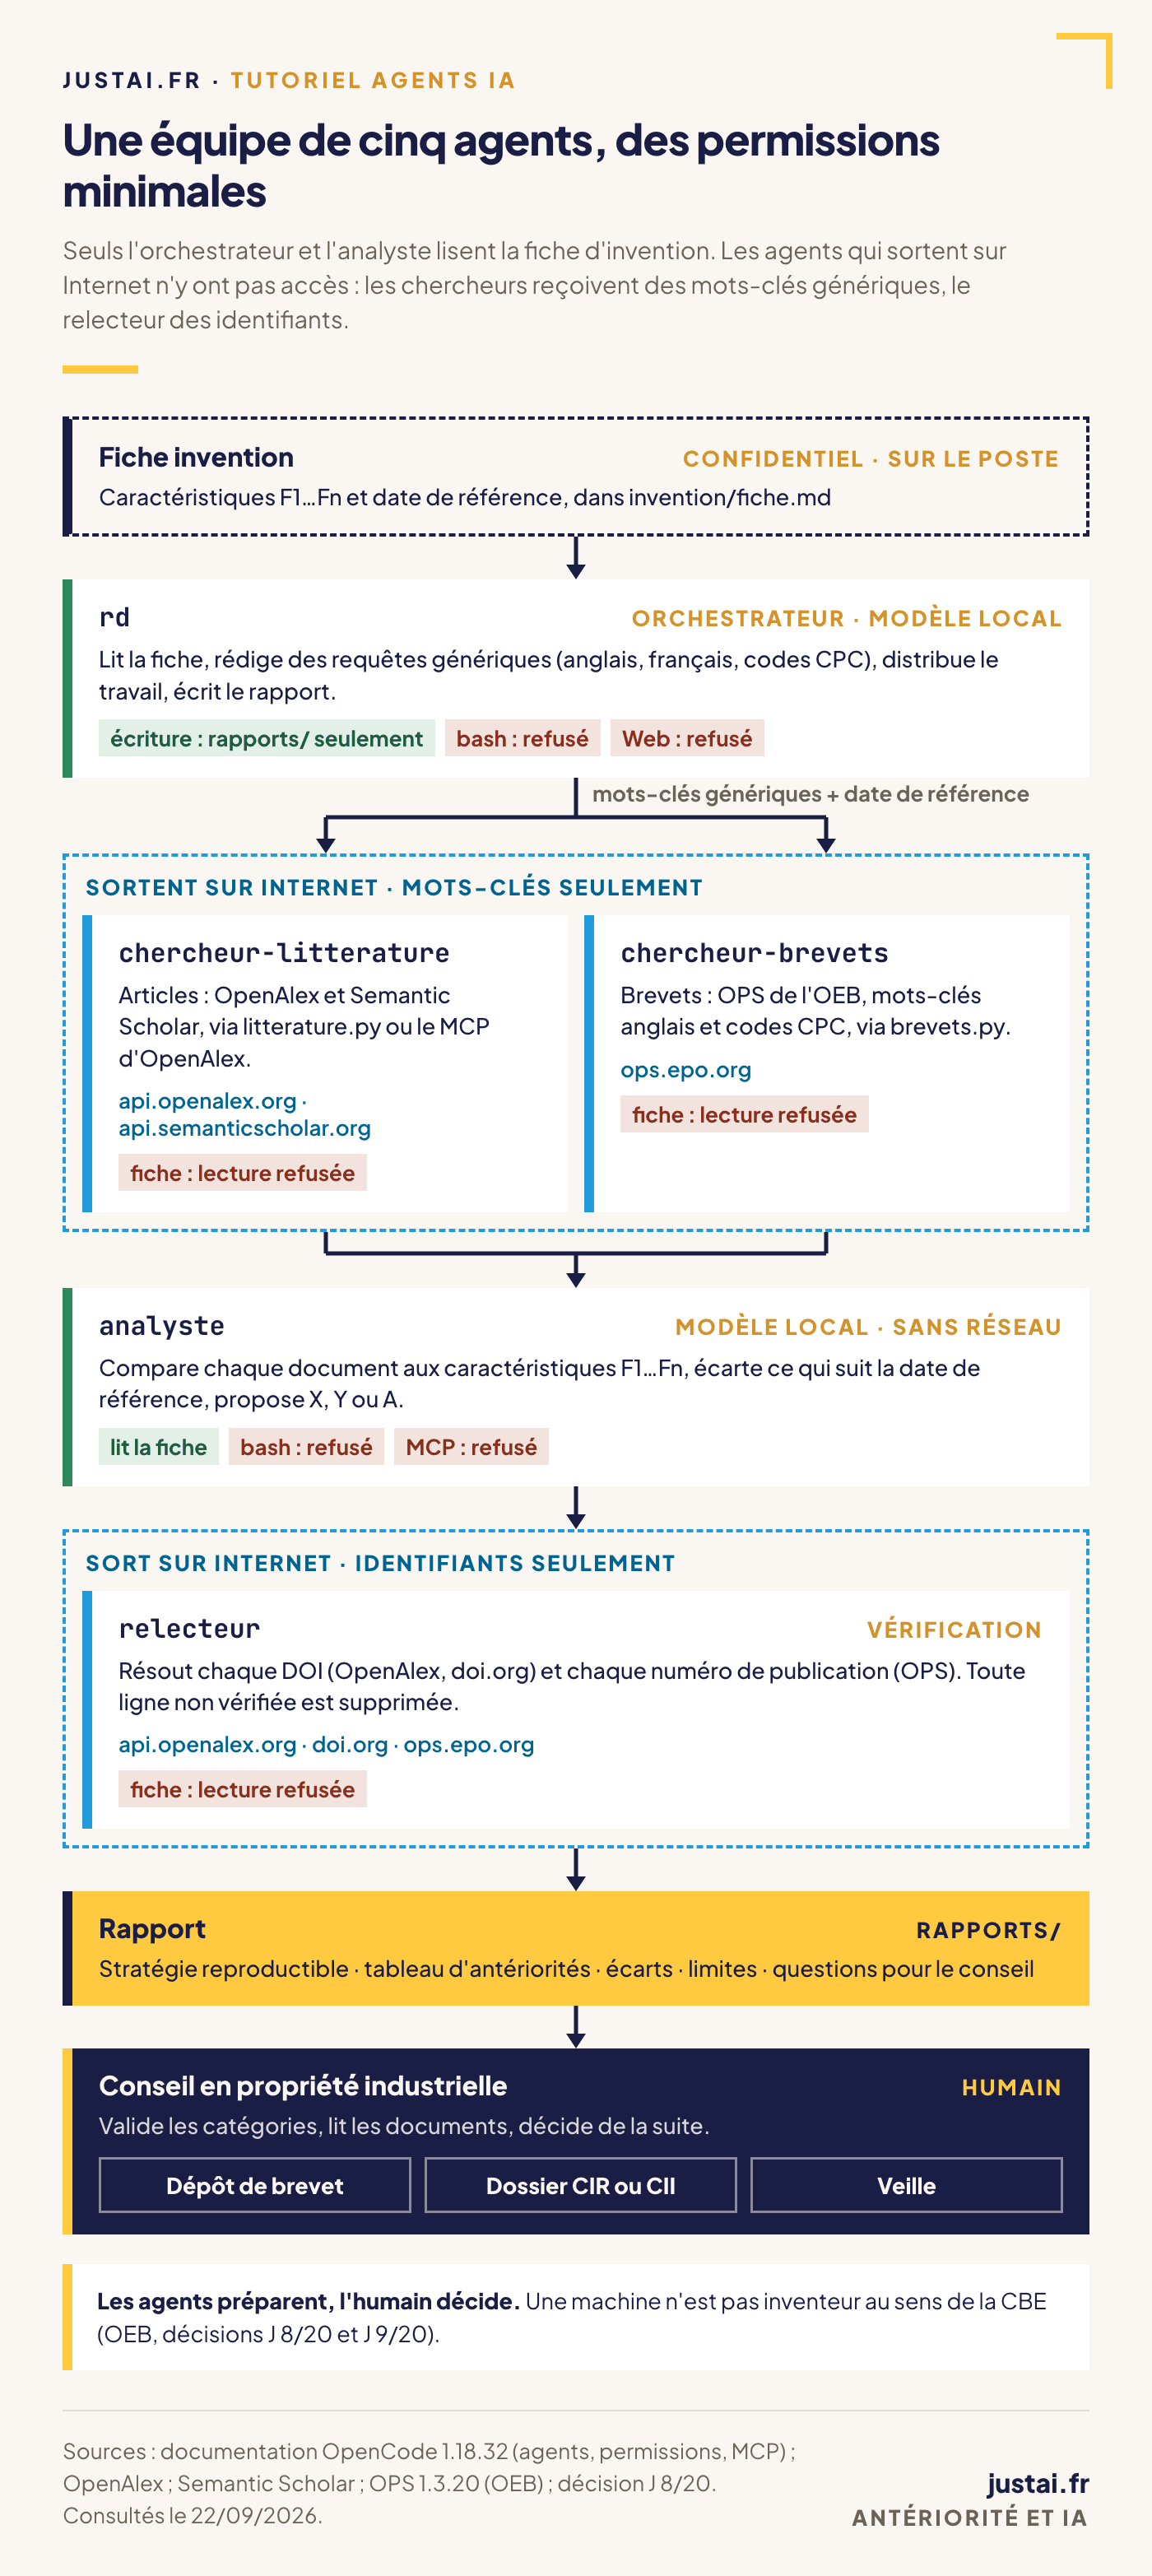
Les fonctions de « deep research » des assistants en ligne enchaînent elles aussi des recherches, mais sur le Web et sur les serveurs de leur éditeur, avec votre question en clair : pour une invention non déposée, c'est ce qu'il faut éviter. De même, un agent unique qui lit la fiche, cherche en ligne et rédige le rapport concentre tous les risques. Découper les rôles permet de donner à chacun des permissions minimales :
rd, l'orchestrateur (agent primaire), lit la fiche, rédige des requêtes génériques, distribue le travail et écrit le rapport ;chercheur-litteratureinterroge OpenAlex et Semantic Scholar ;chercheur-brevetsinterroge OPS, le service web de l'OEB qui puise aux mêmes sources qu'Espacenet ;analystecompare chaque document aux caractéristiques de l'invention, sans accès au réseau ;relecteurvérifie chaque identifiant et supprime toute ligne invérifiable.
Seuls les deux chercheurs et le relecteur sortent sur Internet, et aucun des trois n'a le droit de lire la fiche : les chercheurs ne reçoivent que des mots-clés, le relecteur que des identifiants.
3. Ouvrir l'accès aux sources
| Source | Contenu | Accès | Coût | Pour un agent |
|---|---|---|---|---|
| OpenAlex | Articles, thèses, prépublications (données CC0) | Sans clé ; clé gratuite recommandée | 0,10 $ d'usage par jour sans clé, 1 $ avec | Oui : API et serveur MCP officiel |
| Semantic Scholar | Articles (214 millions selon l'éditeur) | Sans clé (quota partagé) ; clé gratuite sur demande | Gratuit | Oui : API |
| OPS (OEB) | Brevets, mêmes sources qu'Espacenet | Compte validé par l'OEB | Gratuit jusqu'à 4 Go par semaine, 2 800 € par an au-delà | Oui : API |
| Espacenet | Plus de 150 millions de documents brevets, de 1782 à nos jours | Libre | Gratuit | Non : robots interdits |
| Lens.org | Brevets et articles | Jeton sur demande | Essai de 14 jours (usage non commercial) ; commercial sur devis | Sous conditions |
| PATENTSCOPE (OMPI) | Brevets | Recherche web libre | Service web (demandes PCT) : 600 ou 2 000 CHF par an | Payant |
| PatentsView (USPTO) | Brevets américains | — | — | Suspendu depuis le 20 mars 2026 (migration) |
Espacenet reste indispensable, mais pour vous : l'OEB réserve l'interface aux humains, limite chaque adresse IP à 10 actions de recherche par minute et bloque les robots (charte d'usage équitable) ; pour l'automatisation, il renvoie vers OPS. L'INPI diffuse aussi ses données brevets (demandes françaises depuis 1902, européennes et PCT depuis 1978) par API et par FTP, sous une licence de réutilisation ; les modalités d'accès sont décrites sur data.inpi.fr.
OpenAlex
Une clé gratuite porte le budget quotidien de 0,10 $ à 1 $, remis à zéro à minuit UTC (coûts). Une recherche coûte 0,001 $ et une consultation par DOI est gratuite : 1 $ couvre environ 1 000 recherches. Créez un compte sur openalex.org, puis copiez la clé dans Settings → API key.
Semantic Scholar
Sans clé, tous les utilisateurs anonymes se partagent un quota de 1 000 requêtes par seconde : il était saturé pendant nos essais. Demandez une clé par le formulaire de la page API : elle arrive par e-mail et donne 1 requête par seconde. La licence interdit de la communiquer hors de votre organisation et demande de citer « Semantic Scholar » dans les documents publiés qui utilisent ses données.
OPS
Inscrivez-vous sur developers.epo.org. OPS n'accepte aucun accès anonyme et le compte n'est activé qu'après validation par l'OEB. Créez ensuite une application dans My Apps : elle fournit une paire Consumer Key et Consumer Secret.
Rangez les quatre secrets dans votre trousseau ou dans le fichier de configuration de votre shell, jamais dans le projet :
export OPENALEX_API_KEY="..."
export S2_API_KEY="..."
export OPS_KEY="..."
export OPS_SECRET="..."
4. Préparer le projet
Créez un dépôt dédié, avec cette arborescence :
recherche-rd/
├── opencode.json
├── AGENTS.md                            # protocole et règles communes
├── .agents/skills/recherche-anteriorites/
│   ├── SKILL.md                         # mode d'emploi des scripts (OpenCode et pi)
│   └── scripts/
│       ├── litterature.py
│       └── brevets.py
├── .opencode/agents/
│   ├── rd.md
│   ├── chercheur-litterature.md
│   ├── chercheur-brevets.md
│   ├── analyste.md
│   └── relecteur.md
├── invention/fiche.md                   # confidentiel
└── rapports/
mkdir -p recherche-rd/{.agents/skills/recherche-anteriorites/scripts,.opencode/agents,invention,rapports}
cd recherche-rd && git init
Les scripts outils
Le premier interroge OpenAlex et Semantic Scholar, et vérifie des DOI. Une date de référence (--avant) exclut tout document publié ce jour-là ou après.
#!/usr/bin/env python3
"""Articles scientifiques : recherche OpenAlex et Semantic Scholar, vérification de DOI.

  python3 litterature.py openalex '"direct recycling" AND cathode' --avant 2024-01-01
  python3 litterature.py s2 "direct recycling cathode regeneration" --avant 2024-01-01
  python3 litterature.py verifier 10.1016/j.joule.2020.10.008

Clés facultatives, lues dans l'environnement : OPENALEX_API_KEY, S2_API_KEY.
Bibliothèque standard uniquement. Sortie JSON sur la sortie standard.
"""
import argparse
import datetime
import json
import os
import time
import urllib.error
import urllib.parse
import urllib.request

UA = {"User-Agent": "recherche-anteriorites/1.0"}


def http_json(url, entetes=None, essais=5):
    """GET JSON, reprise sur 429 et 5xx, None si 404."""
    for tentative in range(essais):
        req = urllib.request.Request(url, headers={**UA, **(entetes or {})})
        try:
            with urllib.request.urlopen(req, timeout=30) as r:
                return json.load(r)
        except urllib.error.HTTPError as e:
            if e.code == 404:
                return None
            if e.code in (429, 500, 502, 503) and tentative < essais - 1:
                time.sleep(2 ** (tentative + 1))
                continue
            raise SystemExit(f"Erreur {e.code} ({url.split('?')[0]}) : {e.read()[:300]!r}")


def veille(date_ref):
    """Veille de la date de référence : l'antériorité doit la précéder."""
    return (datetime.date.fromisoformat(date_ref) - datetime.timedelta(days=1)).isoformat()


def resume(index):
    """OpenAlex diffuse les résumés en index inversé (mot -> positions)."""
    if not index:
        return ""
    mots = sorted((pos, mot) for mot, positions in index.items() for pos in positions)
    return " ".join(mot for _, mot in mots)


def openalex(requete, avant=None, depuis=None, n=10, titre_resume=False):
    params = {"per_page": min(n, 100),
              "select": "id,doi,title,publication_date,type,primary_location,abstract_inverted_index"}
    filtres = ["type:article|review|preprint"]
    if titre_resume:
        # Titre et résumé seulement. Une virgule séparant deux filtres, on la retire.
        filtres.append("title_and_abstract.search:" + requete.replace(",", " "))
    else:
        params["search"] = requete  # titre, résumé et texte intégral
    if depuis:
        filtres.append(f"from_publication_date:{depuis}-01-01")
    if avant:
        filtres.append(f"to_publication_date:{veille(avant)}")
    params["filter"] = ",".join(filtres)
    cle = os.environ.get("OPENALEX_API_KEY")
    rep = http_json("https://api.openalex.org/works?" + urllib.parse.urlencode(params),
                    {"Authorization": f"Bearer {cle}"} if cle else None)
    docs = []
    for w in rep["results"]:
        loc = w.get("primary_location") or {}
        docs.append({"source": "OpenAlex", "id": w["id"], "doi": w.get("doi"),
                     "titre": w.get("title"), "date": w.get("publication_date"),
                     "type": w.get("type"),
                     "revue": (loc.get("source") or {}).get("display_name"),
                     "lien": w.get("doi") or loc.get("landing_page_url") or w["id"],
                     "resume": resume(w.get("abstract_inverted_index"))[:600]})
    return {"requete": requete, "total": rep["meta"]["count"],
            "cout_usd": rep["meta"].get("cost_usd"), "resultats": docs}


def s2(requete, avant=None, depuis=None, n=10):
    # Semantic Scholar : texte simple, sans opérateurs ; un terme à trait d'union ne trouve rien.
    params = {"query": requete.replace("-", " "), "limit": min(n, 100),
              "fields": "title,externalIds,publicationDate,year,venue,abstract,url"}
    if avant or depuis:
        debut = f"{depuis}-01-01" if depuis else ""
        params["publicationDateOrYear"] = f"{debut}:{veille(avant) if avant else ''}"
    cle = os.environ.get("S2_API_KEY")
    rep = http_json("https://api.semanticscholar.org/graph/v1/paper/search?"
                    + urllib.parse.urlencode(params), {"x-api-key": cle} if cle else None)
    docs = []
    for p in rep.get("data", []):
        doi = (p.get("externalIds") or {}).get("DOI")
        docs.append({"source": "Semantic Scholar", "id": p["paperId"],
                     "doi": f"https://doi.org/{doi}" if doi else None,
                     "titre": p.get("title"), "date": p.get("publicationDate") or p.get("year"),
                     "revue": p.get("venue"), "lien": p.get("url"),
                     "resume": (p.get("abstract") or "")[:600]})
    return {"requete": requete, "total": rep.get("total"), "resultats": docs}


class SansRedirection(urllib.request.HTTPRedirectHandler):
    def redirect_request(self, *args, **kwargs):
        return None  # on veut voir le 302 de doi.org, pas la page de l'éditeur


def verifier(dois):
    """Un DOI est retenu s'il existe dans OpenAlex (gratuit) ou sur doi.org (302)."""
    sortie = []
    for doi in dois:
        doi = doi.replace("https://doi.org/", "").strip()
        w = http_json("https://api.openalex.org/works/doi:" + urllib.parse.quote(doi)
                      + "?select=id,title,publication_date")
        if w:
            sortie.append({"doi": doi, "existe": True, "par": "OpenAlex",
                           "titre": w.get("title"), "date": w.get("publication_date")})
            continue
        try:
            urllib.request.build_opener(SansRedirection).open(
                urllib.request.Request("https://doi.org/" + urllib.parse.quote(doi), headers=UA),
                timeout=30)
            existe = False
        except urllib.error.HTTPError as e:
            existe = e.code in (301, 302, 303, 307, 308)
        sortie.append({"doi": doi, "existe": existe, "par": "doi.org"})
    return sortie


def main():
    p = argparse.ArgumentParser(description=__doc__, formatter_class=argparse.RawTextHelpFormatter)
    sous = p.add_subparsers(dest="commande", required=True)
    for nom in ("openalex", "s2"):
        c = sous.add_parser(nom)
        c.add_argument("requete")
        c.add_argument("--avant", help="date de référence AAAA-MM-JJ (exclue)")
        c.add_argument("--depuis", type=int, help="année minimale")
        c.add_argument("--n", type=int, default=10, help="nombre de résultats (100 au plus)")
        if nom == "openalex":
            c.add_argument("--titre-resume", action="store_true",
                           help="chercher dans le titre et le résumé seulement")
    sous.add_parser("verifier").add_argument("dois", nargs="+")
    a = p.parse_args()
    if a.commande == "openalex":
        r = openalex(a.requete, a.avant, a.depuis, a.n, a.titre_resume)
    elif a.commande == "s2":
        r = s2(a.requete, a.avant, a.depuis, a.n)
    else:
        r = verifier(a.dois)
    print(json.dumps(r, ensure_ascii=False, indent=2))


if __name__ == "__main__":
    main()
Le second interroge OPS. Il suggère des codes de la Classification coopérative des brevets (CPC), cherche dans les titres et résumés anglais (index ta) et vérifie des numéros de publication. OPS sert au plus 100 résultats par requête et 2 000 par recherche : au-delà, resserrez la requête plutôt que de paginer.
#!/usr/bin/env python3
"""Brevets : recherche dans les données de l'OEB via Open Patent Services (OPS 3.2).

  python3 brevets.py classes "battery recycling"             # codes CPC suggérés
  python3 brevets.py chercher --mots "cathode relithiation" --cpc H01M10/54 --avant 2024-01-01
  python3 brevets.py chercher --cql 'ta all "direct recycling" and cpc=/low Y02W30/84'
  python3 brevets.py verifier EP1000000A1 FR3000000A1

Identifiants de votre App developers.epo.org dans OPS_KEY et OPS_SECRET.
Index ti, ab, ta : titres et résumés en anglais. 100 résultats par page, 2 000 par recherche.
"""
import argparse
import base64
import json
import os
import time
import urllib.error
import urllib.parse
import urllib.request

BASE = "https://ops.epo.org/3.2"
JETON = {"valeur": None, "expire": 0.0}


def jeton():
    """OAuth 2.0 « client credentials » : jeton Bearer valable environ 20 minutes."""
    if JETON["valeur"] and time.time() < JETON["expire"] - 60:
        return JETON["valeur"]
    cle, secret = os.environ.get("OPS_KEY"), os.environ.get("OPS_SECRET")
    if not cle or not secret:
        raise SystemExit("Définissez OPS_KEY et OPS_SECRET.")
    basic = base64.b64encode(f"{cle}:{secret}".encode()).decode()
    req = urllib.request.Request(
        f"{BASE}/auth/accesstoken", data=b"grant_type=client_credentials", method="POST",
        headers={"Authorization": f"Basic {basic}",
                 "Content-Type": "application/x-www-form-urlencoded"})
    try:
        with urllib.request.urlopen(req, timeout=30) as r:
            rep = json.load(r)
    except urllib.error.HTTPError as e:
        raise SystemExit(f"Authentification OPS refusée ({e.code}) : {e.read()[:300]!r}")
    JETON["valeur"] = rep["access_token"]
    JETON["expire"] = time.time() + int(rep.get("expires_in", 1199))
    return JETON["valeur"]


def get(chemin, params, plage=None, essais=4):
    url = f"{BASE}/rest-services/{chemin}?" + urllib.parse.urlencode(params)
    for tentative in range(essais):
        h = {"Authorization": f"Bearer {jeton()}", "Accept": "application/json"}
        if plage:
            h["X-OPS-Range"] = plage
        try:
            with urllib.request.urlopen(urllib.request.Request(url, headers=h), timeout=60) as r:
                feux = r.headers.get("X-Throttling-Control") or ""
                if "red" in feux or "black" in feux:
                    time.sleep(10)  # l'OEB demande de ralentir
                return json.load(r)
        except urllib.error.HTTPError as e:
            corps = e.read().decode(errors="replace")
            if e.code == 404:
                return None  # SERVER.EntityNotFound : aucun résultat
            if "invalid_access_token" in corps:
                JETON["valeur"] = None  # jeton expiré : on en redemande un
                continue
            if e.code in (403, 503) and "Fair" not in corps and tentative < essais - 1:
                time.sleep(2 ** (tentative + 2))
                continue
            motif = e.headers.get("X-Rejection-Reason") or ""  # quota épuisé, le cas échéant
            raise SystemExit(f"Erreur OPS {e.code} {motif} : {corps[:400]}")
    raise SystemExit("Nombre maximal de tentatives atteint")


def liste(x):
    return x if isinstance(x, list) else ([] if x is None else [x])


def texte(x):
    """Texte d'un nœud BadgerFish : {'$': ...}, liste de nœuds ou paragraphes."""
    if isinstance(x, list):
        return " ".join(filter(None, (texte(e) for e in x)))
    if isinstance(x, dict):
        return x.get("$") or texte(x.get("p"))
    return x


def en_anglais(noeuds):
    noeuds = liste(noeuds)
    choix = next((n for n in noeuds if n.get("@lang") == "en"), noeuds[0] if noeuds else None)
    return texte(choix) if choix else None


def extraire(doc):
    biblio = doc.get("bibliographic-data") or {}
    ids = liste((biblio.get("publication-reference") or {}).get("document-id"))
    docdb = next((d for d in ids if d.get("@document-id-type") == "docdb"), {})
    date = texte(docdb.get("date")) or ""
    numero = f"{doc.get('@country')}{doc.get('@doc-number')}{doc.get('@kind') or ''}"
    parties = biblio.get("parties") or {}  # élément parfois vide
    deposants = liste((parties.get("applicants") or {}).get("applicant"))
    return {
        "publication": numero,
        "date_publication": f"{date[:4]}-{date[4:6]}-{date[6:]}" if len(date) == 8 else date,
        "titre": en_anglais(biblio.get("invention-title")),
        "deposants": [texte((a.get("applicant-name") or {}).get("name")) for a in deposants
                      if a.get("@data-format") == "original"],
        "famille_simple": doc.get("@family-id"),  # famille simple DOCDB
        "resume": (en_anglais(doc.get("abstract")) or "")[:600],
        # Lien à ouvrir par un humain : Espacenet refuse les robots.
        "espacenet": "https://worldwide.espacenet.com/patent/search?q=pn%3D" + numero,
    }


def chercher(cql, n=25):
    resultats, debut, total = [], 1, 0
    n = min(n, 2000)  # OPS ne sert pas plus de 2 000 résultats par recherche
    while debut <= n:
        fin = min(debut + 99, n)  # 100 résultats au plus par requête
        rep = get("published-data/search/biblio", {"q": cql}, f"{debut}-{fin}")
        if rep is None:
            break
        bs = rep["ops:world-patent-data"]["ops:biblio-search"]
        total = int(bs.get("@total-result-count", 0))
        for bloc in liste((bs.get("ops:search-result") or {}).get("exchange-documents")):
            resultats += [extraire(d) for d in liste(bloc.get("exchange-document"))]
        if fin >= total:
            break
        debut = fin + 1
    return {"cql": cql, "total": total, "partiel": total > len(resultats),
            "resultats": resultats}


def classes(mots):
    rep = get("classification/cpc/search", {"q": mots})
    if rep is None:
        return []
    res = rep["ops:world-patent-data"]["ops:classification-search"]["ops:search-result"]
    return [{"cpc": s.get("@classification-symbol"), "pourcentage": s.get("@percentage")}
            for s in liste(res.get("ops:classification-statistics"))]


def main():
    p = argparse.ArgumentParser(description=__doc__, formatter_class=argparse.RawTextHelpFormatter)
    sous = p.add_subparsers(dest="commande", required=True)
    c = sous.add_parser("chercher")
    c.add_argument("--mots", help="mots anglais, tous présents dans le titre ou le résumé")
    c.add_argument("--cpc", help="code CPC, subdivisions incluses (ex. H01M10/54)")
    c.add_argument("--avant", help="date de référence AAAA-MM-JJ (exclue)")
    c.add_argument("--cql", help="requête CQL complète, prioritaire sur les autres options")
    c.add_argument("--n", type=int, default=25)
    sous.add_parser("classes").add_argument("mots")
    sous.add_parser("verifier").add_argument("numeros", nargs="+")
    a = p.parse_args()

    if a.commande == "classes":
        r = classes(a.mots)
    elif a.commande == "verifier":
        r = []
        for num in a.numeros:
            trouve = chercher(f"pn={num}", 1)["resultats"]
            r.append({"numero": num, "existe": bool(trouve), **(trouve[0] if trouve else {})})
    else:
        clauses = [a.cql] if a.cql else []
        if not a.cql:
            clauses += [f'ta all "{a.mots}"'] if a.mots else []
            clauses += [f"cpc=/low {a.cpc}"] if a.cpc else []
            if not clauses:
                p.error("indiquez --mots, --cpc ou --cql")
            clauses += ["pd<" + a.avant.replace("-", "")] if a.avant else []
        r = chercher(" and ".join(clauses), a.n)
    print(json.dumps(r, ensure_ascii=False, indent=2))


if __name__ == "__main__":
    main()
Premier test
Pour ce tutoriel, nous prenons un sujet public : la régénération directe des cathodes de batteries lithium-ion usagées. Voici la commande exécutée le 22 septembre 2026, sans clé, et un extrait de sa sortie (le premier et le troisième des trois résultats) :
python3 .agents/skills/recherche-anteriorites/scripts/litterature.py openalex \
  '"direct recycling" AND cathode AND relithiation' --avant 2024-01-01 --n 3
{
  "requete": "\"direct recycling\" AND cathode AND relithiation",
  "total": 99,
  "cout_usd": 0.001,
  "resultats": [
    {
      "source": "OpenAlex",
      "id": "https://openalex.org/W3104615841",
      "doi": "https://doi.org/10.1016/j.joule.2020.10.008",
      "titre": "Efficient Direct Recycling of Lithium-Ion Battery Cathodes by Targeted Healing",
      "date": "2020-11-12",
      "type": "article",
      "revue": "Joule",
      "lien": "https://doi.org/10.1016/j.joule.2020.10.008",
      "resume": ""
    },
    {
      "source": "OpenAlex",
      "id": "https://openalex.org/W4282571691",
      "doi": "https://doi.org/10.1016/j.ensm.2022.06.017",
      "titre": "Achieving low-temperature hydrothermal relithiation by redox mediation for direct recycling of spent lithium-ion battery cathodes",
      "date": "2022-06-13",
      "type": "article",
      "revue": "Energy storage materials",
      "lien": "https://doi.org/10.1016/j.ensm.2022.06.017",
      "resume": ""
    }
  ]
}
Deux constats, faits le même jour. D'abord, les résumés manquent souvent : OpenAlex ne les diffuse que sous forme d'index inversé, présent pour plus de 60 % des travaux de 2022 et environ 45 % de ceux d'avant 2000 selon sa documentation, et nous en avons aussi relevé de tronqués ou encombrés de texte de page web. Ensuite, la recherche porte par défaut sur le texte intégral : lithium-ion battery recycling, avant 2024, donnait 19 386 résultats, contre 3 116 avec --titre-resume, qui limite la recherche au titre et au résumé. Les cinq premiers, classés par pertinence, étaient identiques ; la différence se joue plus bas dans la liste. Cette option repose sur le filtre title_and_abstract.search, que la documentation ne recommande plus mais qui fonctionnait toujours le 22 septembre 2026.
La même recherche dans Semantic Scholar, qui n'accepte pas d'opérateurs, comble un de ces trous. Premier des trois résultats, résumé raccourci :
python3 .agents/skills/recherche-anteriorites/scripts/litterature.py s2 \
  "direct recycling cathode relithiation" --avant 2024-01-01 --n 3
{
  "source": "Semantic Scholar",
  "id": "19eb832e9bde5623e3cd3dbbb8331d1187c1c04c",
  "doi": "https://doi.org/10.1016/j.ensm.2022.06.017",
  "titre": "Achieving Low-Temperature Hydrothermal Relithiation by Redox Mediation for Direct Recycling of Spent Lithium-ion Battery Cathodes",
  "date": "2022-06-01",
  "revue": "Energy Storage Materials",
  "lien": "https://www.semanticscholar.org/paper/19eb832e9bde5623e3cd3dbbb8331d1187c1c04c",
  "resume": "Lithium-ion battery (LIB) recycling is an urgent need to address the massive generation of spent LIBs […]"
}
C'est le troisième article d'OpenAlex, cette fois avec son résumé, mais daté du 1er juin 2022 au lieu du 13 juin. La vérification d'un DOI, gratuite, renvoie "existe": false pour un identifiant inventé :
python3 .agents/skills/recherche-anteriorites/scripts/litterature.py verifier 10.1016/j.joule.2020.10.008 10.9999/doi-invente-2024
Une fois votre compte OPS actif, testez brevets.py sur une suggestion de codes CPC, puis sur une recherche :
python3 .agents/skills/recherche-anteriorites/scripts/brevets.py classes "battery recycling"
python3 .agents/skills/recherche-anteriorites/scripts/brevets.py chercher --mots "cathode relithiation" --cpc H01M10/54 --avant 2024-01-01
Le code H01M 10/54 couvre, dans le schéma CPC, la récupération des parties utilisables des accumulateurs usagés ; Y02W 30/84, le recyclage des batteries et piles à combustible.
5. Écrire le protocole : AGENTS.md et le skill
OpenCode charge le fichier AGENTS.md du projet dans le contexte du modèle. Il porte les règles et le protocole communs :
# Recherche d'antériorités : règles communes

## Règles
- Le contenu de invention/fiche.md ne quitte jamais le poste. Aucun outil réseau ne reçoit
  la fiche ni une paraphrase détaillée : seulement des mots-clés génériques.
- Un document n'entre dans le rapport qu'avec un identifiant (DOI, numéro de publication)
  issu d'un outil, jamais de mémoire. Le relecteur le vérifie ; sinon, la ligne est supprimée.
- Aucun avis sur la brevetabilité ni sur la liberté d'exploitation : on propose, le conseil
  en propriété industrielle décide.
- Espacenet est réservé aux humains : fournir le lien, ne jamais l'interroger.

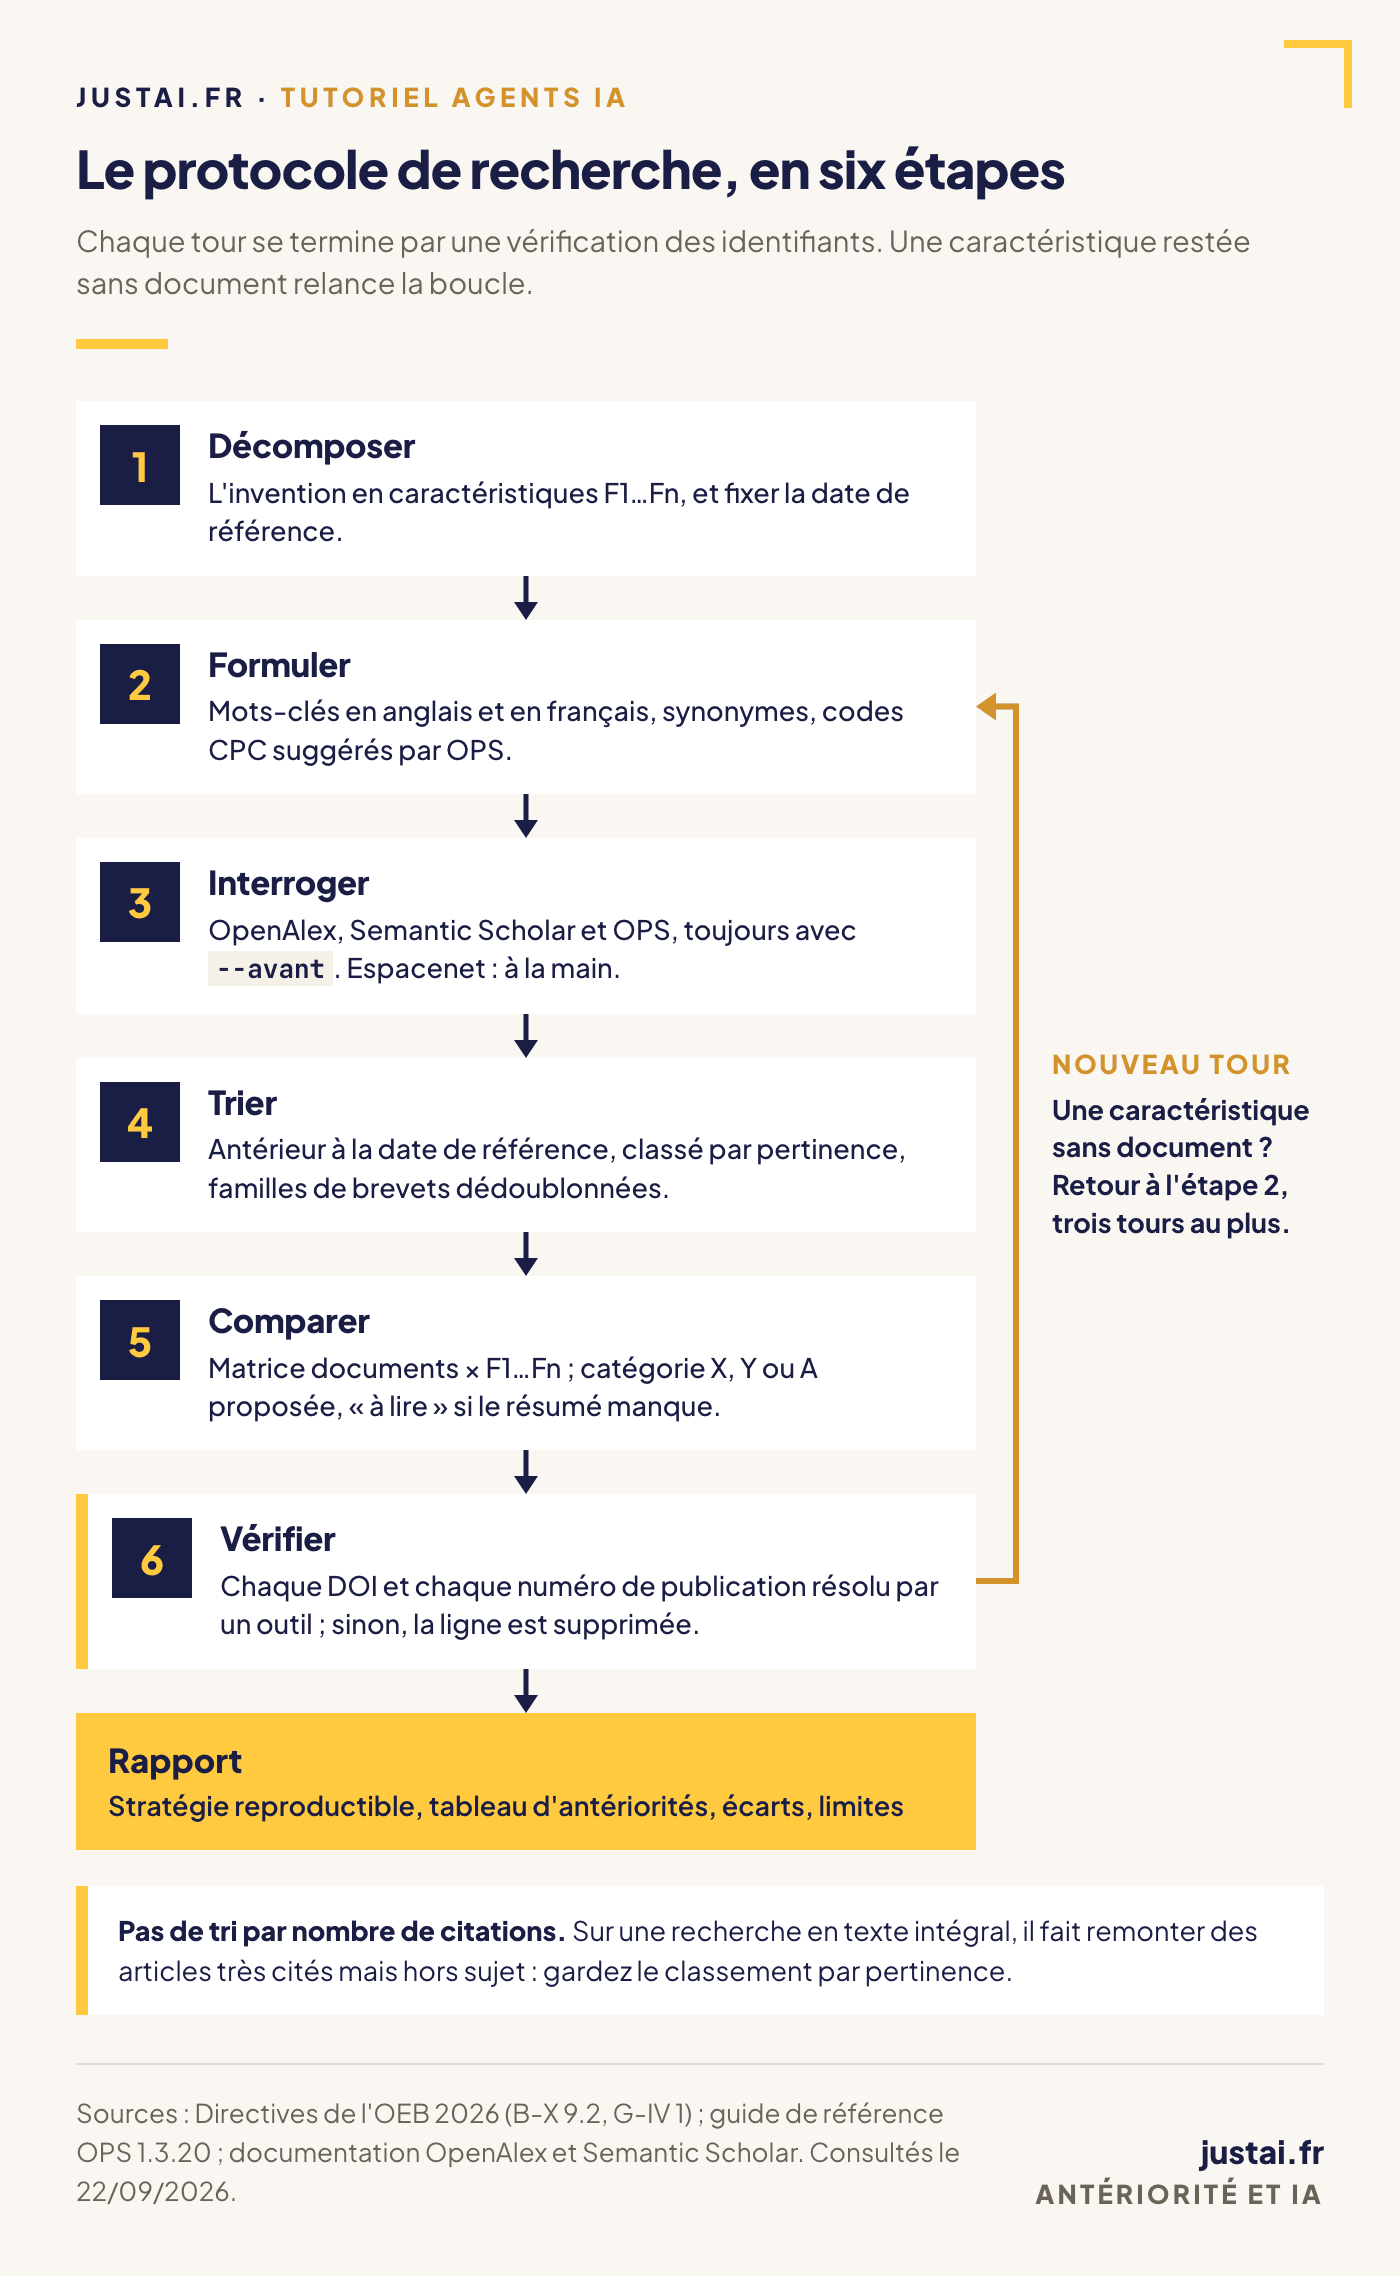
## Protocole
1. Décomposer l'invention en caractéristiques F1…Fn et noter la date de référence.
2. Formuler des requêtes en anglais et en français, avec synonymes ; chercher des codes CPC
   (brevets.py classes).
3. Interroger OpenAlex (--titre-resume si les résultats débordent du sujet), Semantic Scholar
   et OPS (mots-clés anglais et cpc=/low), toujours avec --avant.
4. Trier : écarter tout document daté de la date de référence ou après, garder le tri par
   pertinence, regrouper les brevets d'une même famille simple (famille_simple).
5. Comparer chaque document à F1…Fn ; proposer X, Y ou A.
6. Vérifier chaque identifiant. Si une caractéristique n'a aucun document, reformuler et
   relancer à l'étape 2 : trois tours au plus.

## Format du rapport (rapports/AAAA-MM-JJ-sujet.md)
1. Objet : problème technique, caractéristiques F1…Fn, date de référence.
2. Stratégie : chaque requête exacte, base, date d'exécution, nombre de résultats.
3. Tableau : identifiant vérifié | date | titre | F1…Fn (oui, non, à lire) |
   catégorie proposée | passage qui justifie.
4. Écarts : caractéristiques sans document.
5. Limites : bases non couvertes, langues, résumés absents, requêtes tronquées.
6. Questions pour le conseil en propriété industrielle.
Citer « Semantic Scholar » si le rapport est diffusé et utilise ses données.
Le skill décrit les commandes. OpenCode et pi lisent tous deux .agents/skills/ ; le même fichier sert donc aux deux harness. Créez .agents/skills/recherche-anteriorites/SKILL.md :
---
name: recherche-anteriorites
description: Chercher des articles (OpenAlex, Semantic Scholar) et des brevets (OPS de l'OEB), puis vérifier DOI et numéros de publication, avec les scripts litterature.py et brevets.py.
---

Lancer les scripts depuis la racine du projet, avec ces chemins exacts. Sortie JSON.

Articles (OpenAlex : opérateurs AND, OR, NOT en majuscules et "phrases exactes",
0,001 $ par recherche ; Semantic Scholar : texte simple, sans opérateurs) :
python3 .agents/skills/recherche-anteriorites/scripts/litterature.py openalex '<requête>' --avant AAAA-MM-JJ [--titre-resume] [--n 25]
python3 .agents/skills/recherche-anteriorites/scripts/litterature.py s2 '<mots>' --avant AAAA-MM-JJ
python3 .agents/skills/recherche-anteriorites/scripts/litterature.py verifier <DOI> [<DOI> ...]

Brevets (mots-clés en anglais) :
python3 .agents/skills/recherche-anteriorites/scripts/brevets.py classes '<mots>'
python3 .agents/skills/recherche-anteriorites/scripts/brevets.py chercher --mots '<mots>' [--cpc H01M10/54] --avant AAAA-MM-JJ
python3 .agents/skills/recherche-anteriorites/scripts/brevets.py chercher --cql '<requête CQL>'
python3 .agents/skills/recherche-anteriorites/scripts/brevets.py verifier <numéro> [<numéro> ...]

Après une vérification de brevet, contrôler que le numéro renvoyé correspond au numéro demandé.
Une erreur 429 persistante : attendre, ne pas insister.

Un résumé vide, tronqué ou qui commence par du texte de page web ne permet pas de juger :
marquer « à lire ». Un total supérieur à 2 000 chez OPS : resserrer la requête.
6. Configurer OpenCode
À la racine, opencode.json fixe le modèle local, n'active que ce fournisseur, déclare le serveur MCP officiel d'OpenAlex et pose des permissions globales prudentes :
{
  "$schema": "https://opencode.ai/config.json",
  "model": "ollama/qwen3.6:35b-a3b",
  "small_model": "ollama/qwen3.6:35b-a3b",
  "enabled_providers": ["ollama"],
  "default_agent": "rd",
  "share": "disabled",
  "provider": {
    "ollama": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Ollama (local)",
      "options": { "baseURL": "http://localhost:11434/v1" },
      "models": { "qwen3.6:35b-a3b": { "name": "Qwen3.6 35B A3B (local)" } }
    }
  },
  "mcp": {
    "openalex": { "type": "remote", "url": "https://mcp.openalex.org/mcp" }
  },
  "permission": {
    "edit": "ask",
    "bash": "ask",
    "webfetch": "deny",
    "websearch": "deny",
    "openalex_claim_author_profile": "deny",
    "openalex_submit_curations": "deny"
  }
}
Quelques explications :
- Le modèle. Téléchargez-le (
ollama pull qwen3.6:35b-a3b) et démarrez Ollama avecOLLAMA_CONTEXT_LENGTH=64000 ollama serve, comme dans le tutoriel OpenCode. Un sous-agent sans champmodelutilise le modèle de l'agent qui l'appelle.small_modelfixe le modèle des tâches annexes, comme les titres de session, qu'OpenCode choisit sinon lui-même. enabled_providersne charge que le fournisseur local : une clé OpenRouter enregistrée pour le tutoriel OpenCode est ignorée dans ce projet, et aucun modèle distant ne peut être sélectionné par erreur. Pour un serveur d'inférence sous contrat, déclarez-le dansprovideret ajoutez son identifiant à cette liste.- Le MCP d'OpenAlex est facultatif : les scripts suffisent. Il ajoute notamment
resolve_references, qui contrôle jusqu'à 25 références par appel. Connectez votre compte avecopencode mcp auth openalex, qui ouvre le navigateur ; les requêtes consomment votre budget et, selon OpenAlex, le serveur transmet les arguments à l'API sans stocker les conversations. OpenCode préfixe ses outils par le nom du serveur (openalex_…) : les deux règlesdenycoupent ceux qui modifient votre profil d'auteur. websearchetwebfetchsont interdits : la recherche web d'OpenCode passe par des tiers (Exa ou Parallel), et les liens sont à ouvrir par vous.share: disableddésactive le partage :/sharepublierait la conversation, fiche comprise.
Chaque agent resserre ensuite ces règles. La dernière règle qui correspond l'emporte : "*" vient toujours en premier.
7. Définir les agents
OpenCode lit les agents Markdown dans .opencode/agents/ ; le nom du fichier devient le nom de l'agent, et description est obligatoire. Commencez par l'orchestrateur, .opencode/agents/rd.md :
---
description: Orchestre une recherche d'antériorités et d'état de l'art à partir de invention/fiche.md et rédige le rapport
mode: primary
temperature: 0.1
permission:
  edit:
    "*": deny
    "rapports/*": allow
  bash: deny
  "openalex_*": deny
  task:
    "*": deny
    "chercheur-*": allow
    "analyste": allow
    "relecteur": allow
---
Tu coordonnes la recherche en suivant AGENTS.md.
1. Lis invention/fiche.md : caractéristiques F1…Fn et date de référence.
2. Rédige des requêtes génériques (anglais et français, synonymes). Ne recopie jamais la fiche.
3. Confie les requêtes à @chercheur-litterature et à @chercheur-brevets, avec la date de référence.
4. Transmets leurs résultats et la fiche à @analyste, puis son tableau à @relecteur.
5. Relance l'étape 2 pour toute caractéristique sans document : trois tours au plus.
6. Écris le rapport dans rapports/ au format d'AGENTS.md.
.opencode/agents/chercheur-litterature.md :
---
description: Cherche des articles dans OpenAlex et Semantic Scholar à partir de mots-clés génériques ; renvoie DOI, date, titre et résumé
mode: subagent
temperature: 0.1
permission:
  edit: deny
  read:
    "*": allow
    "*invention/*": deny
  grep: deny
  bash:
    "*": deny
    "python3 .agents/skills/recherche-anteriorites/scripts/litterature.py *": allow
---
Utilise le skill recherche-anteriorites. Lance les requêtes reçues, toujours avec --avant.
Renvoie pour chaque document : DOI ou identifiant, date, titre, revue, résumé et requête exacte.
N'invente jamais un identifiant et ne cherche rien que l'orchestrateur n'a pas demandé.
.opencode/agents/chercheur-brevets.md :
---
description: Cherche des documents brevets via OPS de l'OEB à partir de mots-clés anglais et de codes CPC ; renvoie numéros de publication et requêtes CQL
mode: subagent
temperature: 0.1
permission:
  edit: deny
  read:
    "*": allow
    "*invention/*": deny
  grep: deny
  bash:
    "*": deny
    "python3 .agents/skills/recherche-anteriorites/scripts/brevets.py *": allow
  "openalex_*": deny
---
Utilise le skill recherche-anteriorites. Commence par brevets.py classes pour proposer des
codes CPC, puis combine mots-clés anglais et codes, toujours avec --avant. Renvoie pour chaque
document : numéro de publication, date, titre, déposants, famille, lien Espacenet et requête
CQL exacte. N'invente jamais un numéro.
.opencode/agents/analyste.md :
---
description: Compare chaque document trouvé aux caractéristiques de la fiche invention et propose une catégorie X, Y ou A, sans accès au réseau
mode: subagent
model: ollama/qwen3.6:35b-a3b
temperature: 0.1
permission:
  edit: deny
  bash: deny
  "openalex_*": deny
---
Pour chaque document, remplis une ligne : identifiant, date, F1…Fn (oui, non, à lire),
catégorie proposée, passage qui justifie. Écarte tout document daté de la date de référence
ou après. Si le résumé est absent, tronqué ou parasite, écris « à lire » et ne propose pas X.
Tu proposes ; tu ne conclus ni sur la brevetabilité ni sur la liberté d'exploitation.
.opencode/agents/relecteur.md :
---
description: Vérifie chaque DOI et chaque numéro de publication du tableau avec les outils et supprime toute ligne non vérifiée
mode: subagent
temperature: 0
permission:
  edit: deny
  read:
    "*": allow
    "*invention/*": deny
  grep: deny
  bash:
    "*": deny
    "python3 .agents/skills/recherche-anteriorites/scripts/litterature.py verifier *": allow
    "python3 .agents/skills/recherche-anteriorites/scripts/brevets.py verifier *": allow
---
Vérifie chaque identifiant avec les scripts (ou openalex_resolve_references). Compare le titre
et la date renvoyés à ceux du tableau. Supprime la ligne si l'identifiant n'existe pas, si le
titre ne correspond pas ou si la date n'est pas antérieure à la date de référence. Rends le
tableau corrigé et la liste des lignes supprimées, avec leur motif.
L'analyste reçoit un modèle local explicite, puisqu'il manipule la fiche. Les chercheurs et le relecteur se voient refuser l'outil grep : il renvoie le texte des lignes trouvées, et sa permission porte sur le motif cherché, non sur le fichier lu (code source de l'outil dans OpenCode 1.18.32). Sans cette règle, ils pourraient lire la fiche malgré l'interdiction de read. Avant une vraie recherche, testez deux points que la documentation ne tranche pas : @chercheur-brevets doit se voir refuser la lecture de invention/fiche.md, et les scripts appelés par leur chemin relatif doivent s'exécuter sans demande d'autorisation.
8. Lancer une recherche sur un sujet public
Premier essai : un sujet public, jamais une invention réelle. Créez invention/fiche.md :
Exemple fictif, sujet public.
Date de référence : 2024-01-01

Problème : régénérer le matériau de cathode d'une batterie lithium-ion usagée sans le dissoudre.

- F1 : recyclage direct du matériau de cathode, sans dissolution ni fusion
- F2 : relithiation du matériau en solution
- F3 : traitement à basse température
- F4 : médiateur redox ajouté à la solution
Lancez OpenCode dans le dossier : l'agent rd est actif par défaut.
opencode
Établis l'état de l'art et le tableau d'antériorités pour invention/fiche.md.
Sans interface, opencode run --agent rd "…" fait la même chose. Pendant l'exécution, Leader + Bas ouvre la session du premier sous-agent, Droite et Gauche passent de l'un à l'autre. Vérifiez que les chercheurs n'envoient que des mots-clés datés et que le relecteur lance bien les vérifications.
Nos tests manuels de la section 4 montrent le travail attendu. L'article d'Energy Storage Materials (DOI 10.1016/j.ensm.2022.06.017) arrive par les deux sources. Sans résumé, la ligne OpenAlex ne permet que « à lire ». Le résumé fourni par Semantic Scholar décrit une régénération directe de cathodes NCM usagées par relithiation hydrothermale à basse température, avec un médiateur redox en faible concentration : F1 à F4 semblent tous y figurer. L'analyste peut proposer X ; votre conseil confirmera à la lecture de l'article. L'invention fictive est donc probablement anticipée, et c'est exactement ce qu'il vaut mieux apprendre avant un dépôt.
9. Lire et vérifier le rapport
Le rapport suit les six rubriques d'AGENTS.md. Avant de le transmettre, contrôlez vous-même :
- Chaque identifiant. Ouvrez chaque DOI et chaque lien Espacenet : une ligne sans identifiant vérifiable ne vaut rien.
- Les dates. Seule compte la date à laquelle le document est devenu accessible au public : relevez-la sur la source. Les bases divergent (1er ou 13 juin 2022 ci-dessus). Pour filtrer par date, Semantic Scholar traite un article sans date précise comme publié le 1er janvier de son année, et le script n'affiche alors que l'année : un tel article, paru après la date de référence mais la même année, passe le filtre.
- La couverture. Les index
ti,abettad'OPS ne portent que sur les titres et résumés anglais. Complétez par les codes CPC, les familles et une recherche à la main dans Espacenet, qui traduit les documents. - Les catégories. X, Y et A restent des propositions, et l'OEB ne garantit pas l'exhaustivité d'OPS (article 7.2 de ses conditions).
Pour une veille, relancez la même stratégie à intervalle fixe en ne gardant que les nouveautés (pd>=AAAAMMJJ en CQL, --depuis pour les articles). Pour un dossier CIR, le rapport fournit la bibliographie ; l'analyse critique du verrou reste à rédiger.
Sécurité et confidentialité
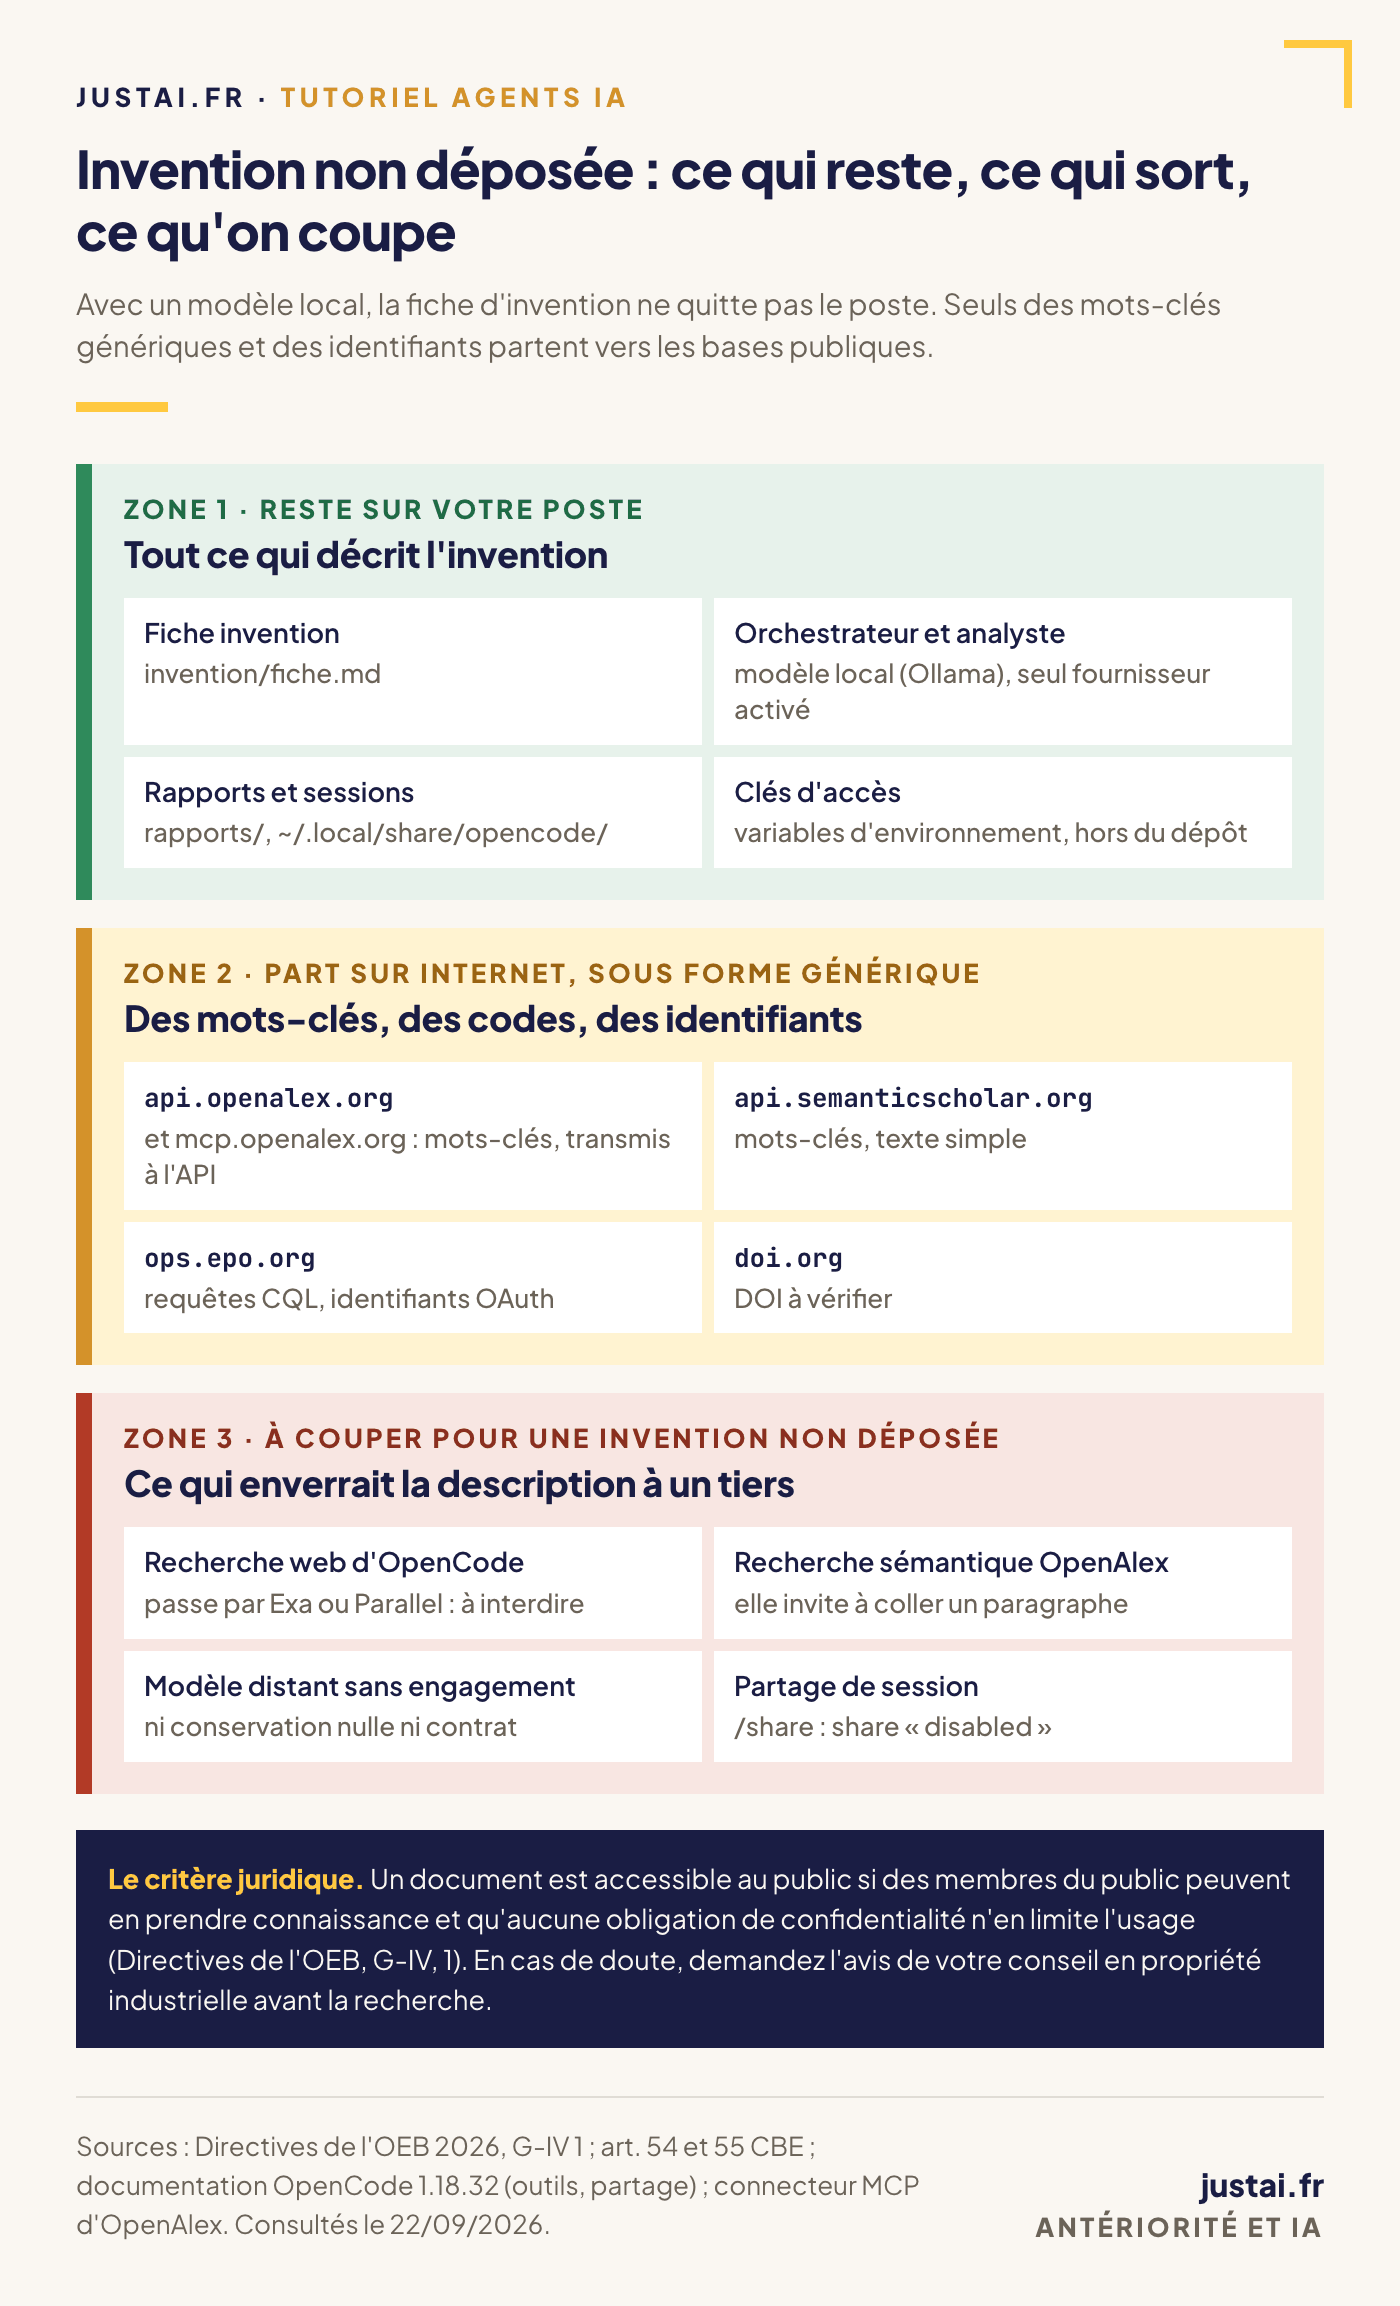
Le modèle. Chaque requête au modèle contient ce que l'agent a lu, fiche comprise. Pour une invention non déposée, trois options : un modèle local servi par Ollama ; un serveur d'inférence dédié, hébergé en France et couvert par un contrat de confidentialité, ce que propose JustAI (IA souveraine) ; à défaut, un fournisseur qui s'engage par contrat à ne rien conserver ni réutiliser. Le routage d'OpenRouter limité aux fournisseurs à conservation nulle (ZDR), décrit dans le tutoriel OpenCode, reste réservé aux sujets publics tant que votre conseil n'a pas validé ses conditions.
Ce qui sort. Des mots-clés et des codes CPC vers api.openalex.org, mcp.openalex.org, api.semanticscholar.org et ops.epo.org ; des DOI et des numéros de publication à vérifier vers api.openalex.org, doi.org et ops.epo.org. Une série de requêtes très précises peut malgré tout dessiner l'invention : restez générique, et n'utilisez pas la recherche sémantique d'OpenAlex, qui invite à coller un paragraphe.
Le droit. Nous ne soutenons pas qu'une requête à un service d'IA vaille divulgation au sens de l'article 54 CBE : le critère est l'accessibilité au public en l'absence d'obligation de confidentialité, et l'effet d'un envoi dépend des engagements du destinataire. En cas de doute, interrogez votre conseil avant la recherche.
Les traces. OpenCode conserve les sessions dans ~/.local/share/opencode/, fiche comprise : protégez ce dossier comme la fiche. En cas de fuite d'une clé, faites-la tourner dans Settings → API key chez OpenAlex, en choisissant l'expiration immédiate de l'ancienne ; chez l'OEB, créez une nouvelle application dans My Apps et faites désactiver l'ancienne, au besoin par le support d'OPS (patentdata@epo.org).
Les conditions d'usage. Les conditions d'OPS interdisent de republier telles quelles les données obtenues.
Transposer à pi
JustAI utilise pi en interne, avec ses propres extensions. Le montage s'y transpose avec trois différences, pi n'intégrant ni sous-agents, ni MCP, ni permissions :
- Les sous-agents viennent de l'extension d'exemple
subagentdu dépôt de pi : chaque sous-agent tourne dans un processus pi séparé, en mode simple, parallèle (8 tâches au plus, 4 simultanées) ou en chaîne. Les agents se déclarent dans~/.pi/agent/agents/*.mdavec les champsname,description,toolsetmodel(facultatif : sans lui, le sous-agent reprend le modèle de la session). Les agents du projet, dans.pi/agents/, ne se chargent qu'avecagentScope: "project"ou"both". - Pas de MCP : les chercheurs appellent
litterature.pyetbrevets.pypar l'outilbash, guidés par le même skill, que pi trouve dans.agents/skills/. Pi lit aussiAGENTS.md. - Pas de permissions : limitez les outils de chaque agent (
tools: read, grep, find, lspour l'analyste, sansbash) et faites tourner l'ensemble dans le conteneur décrit dans le tutoriel pi. Un chercheur qui dispose debashpeut toutefois lire la fiche : le cloisonnement d'OpenCode n'a pas d'équivalent direct.
Dépannage
- OpenAlex, erreur 429 : budget du jour épuisé ou plus de 100 requêtes par seconde. Ajoutez une clé ; les consultations par DOI restent gratuites.
- OpenAlex, erreur 400 « Request URL too long » : l'URL dépasse environ 4 Ko. Découpez la requête booléenne.
- Semantic Scholar, erreur 429 répétée : le quota anonyme est saturé. Demandez une clé et respectez 1 requête par seconde.
- OPS, 401 « ClientId is Invalid » :
OPS_KEYouOPS_SECRETerroné. - OPS, 403 mentionnant le « Fair Use » : quota dépassé, le script s'arrête ; l'en-tête
X-Rejection-Reasonprécise lequel. Le quota horaire se reconstitue en une heure au plus, le quota hebdomadaire la semaine suivante (du lundi 0 h au dimanche 24 h GMT). D'ici là, réduisez les volumes. - OPS, 400
CLIENT.CQL: requête CQL invalide. Testez-la par petits morceaux ; pour un code CPC, essayez aussicpc=H01M10/54, sans/low. - Le MCP d'OpenAlex ne répond pas :
opencode mcp debug openalex, puisopencode mcp auth openalex. - Un script est refusé : l'agent l'a appelé autrement que par
python3 .agents/skills/…. Rappelez-lui la commande du skill. - Des résultats hors sujet : passez
--titre-resume, ajoutez un code CPC ou des « phrases exactes ».
Aller plus loin
- Installer le harness : OpenCode, pi ou Hermes Agent, et les comparer : Claude Code vs OpenCode, Hermes et pi.
- Comprendre le protocole qui relie les agents aux sources : MCP (Model Context Protocol).
- Mesurer ce que deviennent les données confiées à un assistant en ligne : ChatGPT en entreprise et RGPD.
- Concevoir et sécuriser vos propres équipes d'agents : formation agents IA.
- Faire tourner ces agents sur des modèles hébergés en France : IA souveraine.