Ce qu'il faut retenir
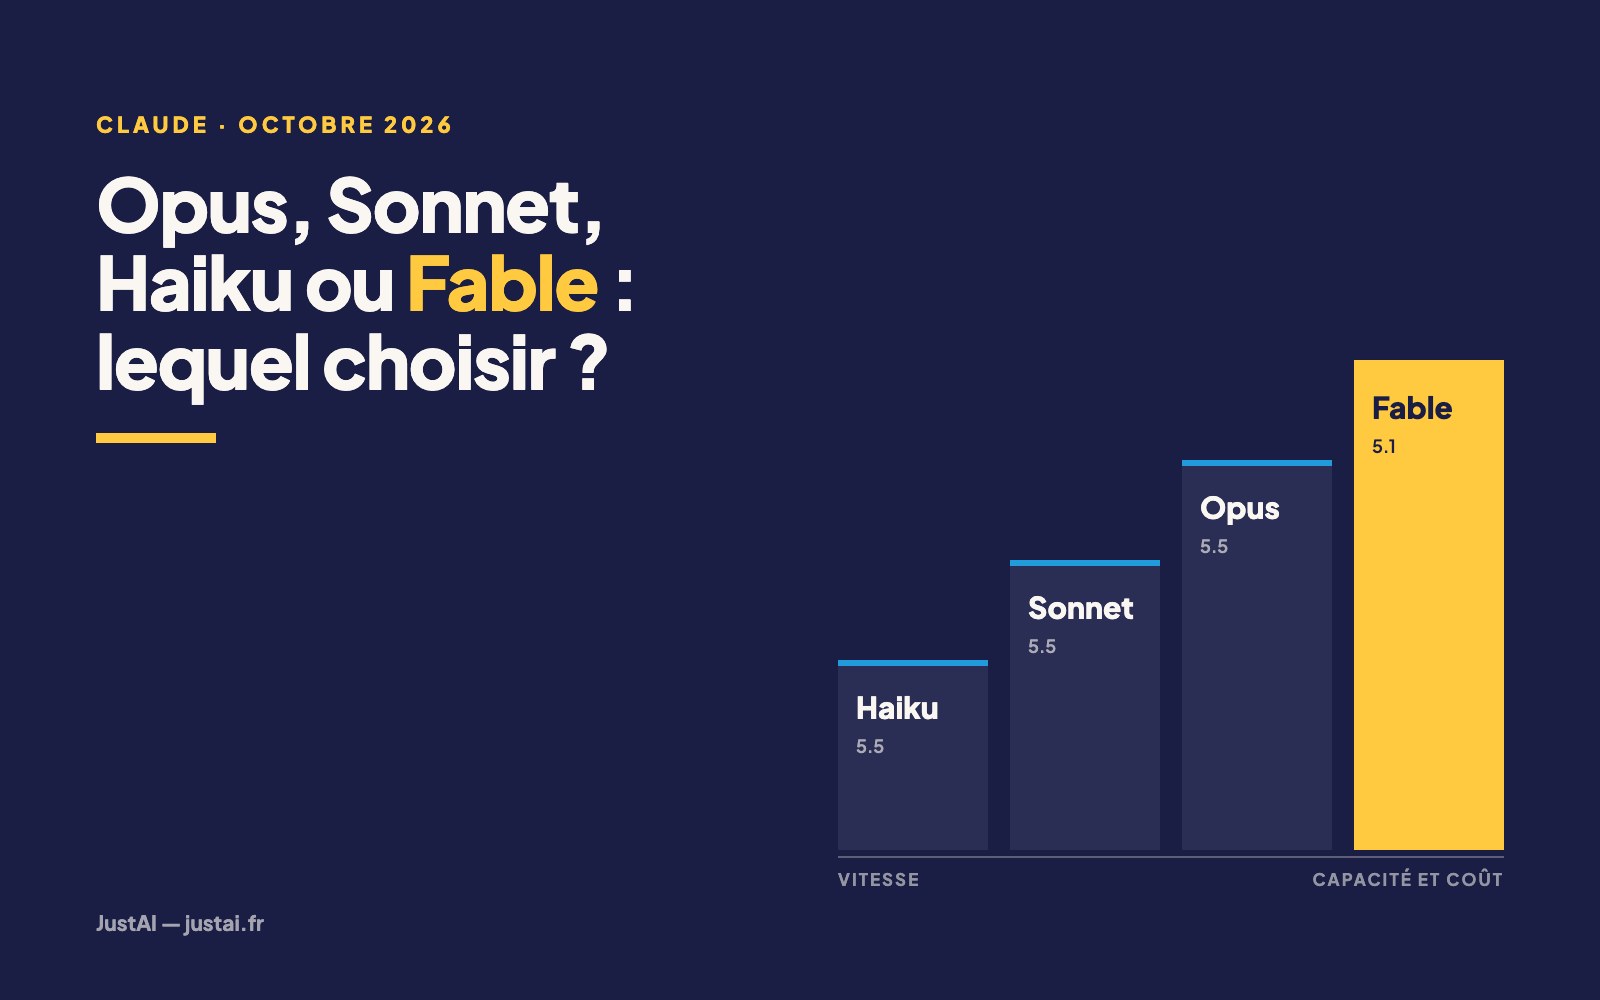
- Quatre modèles, quatre niveaux de prix par million de jetons (entrée / sortie) : Fable 5.1 à 10 $ / 50 $, Opus 5.5 à 4 $ / 20 $, Sonnet 5.5 à 2 $ / 10 $, Haiku 5.5 à 0,10 $ / 0,50 $ sous 100 000 jetons de prompt.
- Claude Opus 5.5 est le point de départ recommandé par Anthropic et le modèle par défaut de Claude Code, sur les abonnements Pro, Max, Team et Enterprise comme sur l'API. Fable 5.1 se réserve au raisonnement le plus exigeant et aux tâches où Opus 5.5 échoue encore avec un effort élevé.
- Opus 5.5 coûte 20 % de moins qu'Opus 5 au tarif, 60 % de moins sur la lecture du cache, et environ 40 % de moins sur des charges typiques selon Anthropic.
- Le bon critère est le coût par tâche réussie. Sur un banc de corrections de code mesuré par Anthropic, Opus 5.5 résout autant de tâches que Fable 5.1 pour environ un cinquième du coût.
- Régler l'effort rapporte souvent plus que changer de modèle : tout lancer en effort bas, puis relancer les seuls échecs en effort élevé, coûte environ 40 % de moins qu'un effort élevé partout, à réussite égale.
Claude 5.5 : qu'est-ce qui a changé entre septembre et octobre 2026 ?
Choisir entre Claude Opus, Sonnet, Haiku et Fable est devenu une décision de coût autant que de qualité. En cinq semaines, Anthropic a renouvelé sa gamme : Fable 5.1 le 1er septembre, Opus 5.5 le 22 septembre, Sonnet 5.5 le 28 septembre et Haiku 5.5 le 7 octobre 2026. Les quatre modèles ont une fenêtre de contexte d'un million de jetons, une sortie maximale de 128 000 jetons et des connaissances arrêtées à juin 2026.
| Modèle | Entrée / sortie (par million de jetons) | Lecture du cache | Effort par défaut (API) | Usage visé par Anthropic |
|---|---|---|---|---|
| Fable 5.1 | 10 $ / 50 $ | 0,25 $ | high |
Raisonnement exigeant, travail agentique de longue durée |
| Opus 5.5 | 4 $ / 20 $ | 0,20 $ | medium |
Code agentique de longue durée, travail intellectuel |
| Sonnet 5.5 | 2 $ / 10 $ | 0,10 $ | high |
Compromis entre vitesse et intelligence |
| Haiku 5.5 | 0,10 $ / 0,50 $ jusqu'à 100 000 jetons de prompt ; 0,50 $ / 2,50 $ au-delà | 0,01 $ / 0,05 $ | medium |
Gros volumes, faible latence : classification, extraction, routage |
Claude Mythos 5.1 est le même modèle que Fable 5.1, au même prix, avec des garde-fous différents. Il est réservé aux programmes de vérification d'Anthropic (cybersécurité défensive, sciences du vivant) et, pour l'instant, à des organisations américaines. Sur ces garde-fous, voir la controverse du lancement de Fable 5, en juin.
Claude Opus 5.5 : pourquoi c'est le point de départ recommandé
La documentation d'Anthropic est explicite : en cas de doute, commencer par Claude Opus 5.5, et réserver Fable 5.1 au raisonnement exigeant, au travail agentique de longue durée, ou aux cas où les évaluations d'Opus 5.5 restent insuffisantes en effort xhigh ou max.
Les chiffres de l'éditeur vont dans ce sens. Dans le tableau publié avec Opus 5.5, il devance Fable 5.1 sur les neuf évaluations, réglé à l'effort maximal : 66,4 % contre 55,8 % sur Terminal-Bench 4.0 (en xhigh), 1 846 contre 1 735 points Elo sur GDPval-AA, qui mesure le travail intellectuel. Anthropic précise toutefois que l'écart réel est plus étroit que ne le suggèrent ces scores. Sur le coût, en revanche, l'écart est net : sur un sous-ensemble de SWE-bench Pro, un banc de corrections de code, Opus 5.5 à son effort par défaut résout 92,8 % des tâches pour 0,22 $ par tâche résolue, Fable 5.1 en résout 92,3 % pour 1,19 $.
Claude Opus 5 ou Opus 5.5 : ce qui change
Le tarif baisse de 20 % (4 $ et 20 $ contre 5 $ et 25 $), la lecture du cache de 60 % (0,20 $ contre 0,50 $). La génération est plus de 30 % plus rapide. L'effort par défaut descend de high à medium : selon Anthropic, Opus 5.5 en medium égale ou dépasse Opus 5 en high sur ses évaluations de code et de travail intellectuel. Sur le sous-ensemble SWE-bench Pro, la réussite passe de 91,9 % à 92,8 % pour 78 % de moins par tâche résolue. Même aux prix d'Opus 5, la baisse serait d'environ 69 % : l'économie vient surtout de jetons consommés en moins.
Pour une application qui appelle Opus 5 par l'API, quatre points sont à vérifier avant de changer d'identifiant :
- La réflexion ne se désactive plus : la couper renvoie une erreur 400, il faut baisser l'effort.
- L'appel d'outil forcé (
tool_choiceàanyoutool) renvoie une erreur ; Anthropic conseilleautoavec un schéma strict. - L'ancien outil de pilotage d'ordinateur (
computer_20251124) est refusé sur l'API et Google Cloud, pas sur Bedrock. - Le texte entre deux appels d'outils arrive dans des blocs de réflexion, vides par défaut : une interface qui affichait cette progression devient muette, sans erreur.
Claude Fable 5.1 : quand le haut de gamme se justifie
Fable 5.1 est le modèle le plus capable qu'Anthropic ouvre à tous ses clients. L'éditeur lui attribue les sessions d'agent de plusieurs heures, la recherche en plusieurs étapes et les analyses menées jusqu'au livrable fini (document, tableur, présentation). La documentation de Claude Code y ajoute les problèmes ambigus : cause racine d'un incident, décision d'architecture.
Trois contraintes pèsent sur ce choix :
- Le prix, qui ne se justifie que si vos évaluations montrent le gain. Sur DeepResearch Bench II, un banc de recherche approfondie, Fable 5.1 obtient 66 % en effort
lowpour 4,48 $ par tâche et 65 % enhighpour 6,89 $ : l'effort élevé n'a rien apporté. - La conservation des données : 30 jours imposés, pas de conservation nulle sauf autorisation expresse d'Anthropic.
- Les refus : ses classificateurs de sécurité, surtout en cybersécurité et en biologie, peuvent bloquer une requête ; un mécanisme de repli, automatique dans Claude Code et à activer sur l'API, la rejoue alors sur Opus 4.8 (cybersécurité) ou Opus 5 (biologie).
Dans Claude Code, Fable n'est le modèle par défaut d'aucun abonnement : il se choisit avec /model fable. Selon l'abonnement et le siège, son usage peut être décompté en crédits d'usage plutôt que sur les limites incluses, sans confirmation en mode non interactif (-p).
Claude Sonnet 5.5 : pour quelles tâches ?
Anthropic positionne Claude Sonnet 5.5 sur les tâches courantes au périmètre clair : corriger un bug, produire un document, une présentation ou un tableur. Opus 5.5 reste, selon l'éditeur, nettement meilleur sur le travail ouvert qui demande un jugement soutenu.
Le 7 octobre, Anthropic a divisé par deux la lecture du cache de Sonnet 5.5 (0,10 $ au lieu de 0,20 $), soit environ 20 % de moins sur la plupart des tâches agentiques. Depuis, chaque tarif d'Opus 5.5 vaut exactement le double. Pourtant, sur le sous-ensemble SWE-bench Pro, Opus 5.5 en effort low résout autant de tâches que Sonnet 5.5 à son réglage par défaut (87,4 % contre 87,6 %), pour environ 7 % de plus par tâche résolue. Si vos développeurs sont déjà sur Opus 5.5, baisser l'effort est souvent plus simple que changer de modèle. Passer d'Opus 5.5 à Sonnet 5.5 en cours de conversation a d'ailleurs un coût caché : Sonnet 5.5 ne lit pas les blocs de réflexion d'Opus 5.5, que l'API écarte, et le cache est perdu à partir de ces blocs.
Sonnet 5.5 garde l'avantage de la vitesse. Face à Sonnet 5, dont il reprend les tarifs d'entrée et de sortie, il gagne environ 10 points sur le même banc pour 87 % de moins par tâche résolue. Passer son effort de high à medium coûte environ 7 points, pour 59 % du coût par tâche.
Claude Haiku 5.5 : le modèle des gros volumes
Claude Haiku 5.5 est annoncé 90 % moins cher que Haiku 4.5 sous 100 000 jetons, et environ 75 % moins cher en moyenne à l'usage. Son tokeniseur compte environ 30 % de jetons en plus pour le même texte : à texte égal, l'économie sur l'entrée reste d'environ 87 %, selon notre calcul. C'est aussi le premier Haiku doté d'un réglage d'effort (medium par défaut).
Sur GPQA Diamond (questions scientifiques), il atteint 85 % de bonnes réponses contre 91 % pour Opus 5.5 et Sonnet 5.5, pour environ un vingtième du coût d'Opus 5.5 par bonne réponse. Sur un jeu de 79 tâches d'agents, la réussite passe de 62 % avec Haiku 4.5 à 93 %, pour environ 84 % de moins par tentative réussie.
Le seuil de 100 000 jetons, piège tarifaire
Au-delà de 100 000 jetons de prompt, cache compris, toute la requête passe au tarif supérieur, cinq fois plus cher. Exemple illustratif : un prompt de 99 000 jetons coûte environ 0,0099 $ en entrée, un prompt de 101 000 jetons environ 0,0505 $. Dans un assistant documentaire de type RAG, il faut donc plafonner les passages injectés.
Côté code, le budget de réflexion fixe et le préremplissage de la réponse renvoient désormais une erreur, comme presque toutes les valeurs de temperature, top_p et top_k : Anthropic conseille de les omettre. Sur Bedrock, les sorties structurées ne sont pas disponibles.
Quel modèle Claude choisir selon la tâche ?
Cette grille de départ s'appuie sur les recommandations et les mesures d'Anthropic ; elle ne remplace pas un essai sur vos données.
| Tâche | Modèle de départ | Effort de départ | Changer si… |
|---|---|---|---|
| Agent autonome de plusieurs heures, recherche en plusieurs étapes, livrable complet | Fable 5.1 | high, puis tester low |
Opus 5.5 en xhigh fait aussi bien : revenir à Opus |
| Refactorisation ou migration à l'échelle d'un dépôt | Opus 5.5 | high ou xhigh |
Les évaluations échouent encore : essayer Fable 5.1 |
| Revue de code, audit d'un module | Opus 5.5 | high (max pour chercher des failles) |
Volume de revues élevé : Opus 5.5 en medium |
| Fonctionnalité au périmètre clair, correction de bug | Opus 5.5 ou Sonnet 5.5 | medium ; high pour un bug dans un code existant |
Tests automatiques et gros volume : Opus 5.5 en low |
| Assistant interne (procédures, qualité, RH) | Sonnet 5.5 | medium |
Questions simples, gros volume : Haiku 5.5 |
| Extraction documentaire (factures, bons de livraison, fiches) | Haiku 5.5, prompt sous 100 000 jetons | low ou medium |
Graphiques et schémas denses : Opus 5.5, plus précis sur les visuels |
| Classification, routage, résumé court | Haiku 5.5 | medium |
Taux d'erreur mesuré trop élevé : Sonnet 5.5 |
| Sous-agents d'exploration dans Claude Code | Haiku 5.5 | low |
Synthèses insuffisantes : Sonnet 5.5 |
Une règle simple : quand le résultat se vérifie (tests, schéma, contrôle croisé), partez du modèle le moins cher et montez si le taux d'échec l'impose. Quand il se vérifie mal, comme une revue d'architecture, partez d'Opus 5.5 et ne descendez qu'après mesure.
Combien coûte une tâche avec Claude Opus, Sonnet ou Haiku ?
Le prix au million de jetons ne dit pas ce que coûte une tâche. Un modèle plus capable finit parfois en moins d'étapes ; la réflexion, facturée comme des jetons de sortie même non affichée, alourdit au contraire la note. Mesures d'Anthropic sur le sous-ensemble SWE-bench Pro :
| Modèle et effort | Tâches résolues | Coût par tâche résolue |
|---|---|---|
Sonnet 5.5, high (défaut) |
87,6 % | 0,11 $ |
Opus 5.5, low |
87,4 % | 0,12 $ |
Opus 5.5, medium (défaut) |
92,8 % | 0,22 $ |
Fable 5.1, high (défaut, un seul passage) |
92,3 % | 1,19 $ |
Rapporté cette fois à chaque tâche tentée, le coût d'Opus 5.5 va de 0,11 $ en low (87,4 % de réussite) à 0,29 $ en high (95,3 %) et 0,74 $ en xhigh (96,7 %). En lançant tout en low puis en relançant les seuls échecs en high, Anthropic obtient environ 97 % de réussite pour 0,17 $ par tâche. Il faut pour cela un résultat vérifiable automatiquement, par des tests.
Exemple illustratif : 1 000 documents de 20 000 jetons, avec 1 000 jetons de réponse chacun, soit 20 millions de jetons en entrée et un million en sortie. Au tarif catalogue, hors cache et hors réflexion : 2,50 $ avec Haiku 5.5, 50 $ avec Sonnet 5.5, 100 $ avec Opus 5.5, 250 $ avec Fable 5.1. Moitié prix en traitement par lots.
Deux leviers passent avant le choix du modèle. Le cache d'abord : selon Anthropic, ses lectures sont régulièrement le premier poste de coût d'une tâche, ce qui le rend plus rentable que la plupart des choix de modèle. Le traitement par lots ensuite, quand la réponse peut attendre. Pour comparer deux efforts, utilisez des sessions séparées : changer l'effort en cours de session invalide le cache. Dans Claude Code, Anthropic constate en entreprise un coût moyen d'environ 13 $ par développeur et par jour d'activité (détails dans Claude Code en équipe).
Que change la gamme 5.5 dans Claude Code ?
Le modèle par défaut est Opus 5.5 sur Pro, Max, Team et Enterprise, sur l'API, sur Bedrock et sur Google Cloud ; Microsoft Foundry reste sur Sonnet 4.5. Depuis la version 2.1.280 du 22 septembre, Pro et Team Standard sont passés de Sonnet à Opus. Une équipe qui n'a rien changé tourne donc sur Opus.
Haiku 5.5 n'est pas le modèle par défaut de Claude Code. Depuis la version 2.1.293 du 7 octobre, c'est le modèle Haiku par défaut sur l'API d'Anthropic : celui de l'alias haiku et de certaines tâches d'arrière-plan.
L'effort par défaut est medium sur Opus 5.5, Sonnet 5.5 et Haiku 5.5. La documentation associe medium au travail courant au périmètre clair, high aux tâches où la vérification compte, max aux problèmes difficiles comme la recherche de failles.
Chaque sous-agent peut avoir son modèle et son effort. La définition d'un sous-agent peut fixer les deux ; depuis la version 2.1.292 du 6 octobre, Claude peut aussi choisir l'effort à chaque lancement d'un sous-agent :
---
name: tri-des-tickets
description: Classe les tickets entrants par composant et par gravité
model: haiku
effort: low
---
Sans modèle déclaré, choisi par Claude ou fixé par la variable CLAUDE_CODE_SUBAGENT_MODEL, un sous-agent hérite du modèle de la conversation : si vous passez sur Fable, vos sous-agents vous suivent. Exception : avec un abonnement Claude ou un compte API Anthropic, le sous-agent intégré Explore passe alors sur Opus.
Claude en Europe : que permet Bedrock depuis Paris ?
L'API directe d'Anthropic n'offre aucune option européenne : inférence mondiale par défaut ou limitée aux États-Unis (tarif multiplié par 1,1), stockage aux États-Unis (voir Claude en entreprise : offres et données).
Sur Amazon Bedrock, depuis Paris (eu-west-3), Opus 5.5, Sonnet 5.5 et Haiku 5.5 passent soit par le point de terminaison mondial, soit par le profil d'inférence EU, qui répartit les requêtes entre six régions européennes (Francfort, Stockholm, Milan, Espagne, Irlande et Paris), selon AWS. Aucun traitement limité à Paris n'est proposé, et le profil EU coûte 10 % de plus que le routage mondial selon Anthropic. Fable 5.1 n'est proposé qu'en routage mondial depuis l'Europe.
Dans Claude Code sur Bedrock, les alias sonnet et haiku pointent encore vers Sonnet 4.5 et Haiku 4.5. Il faut fixer les identifiants des profils EU, publiés par AWS :
export CLAUDE_CODE_USE_BEDROCK=1
export AWS_REGION=eu-west-3   # le modèle par défaut devient eu.anthropic.claude-opus-5-5
export ANTHROPIC_DEFAULT_SONNET_MODEL='eu.anthropic.claude-sonnet-5-5'
export ANTHROPIC_DEFAULT_HAIKU_MODEL='eu.anthropic.claude-haiku-5-5'
Reste le fond : Amazon est une entreprise américaine, et un routage européen ne soustrait pas les données au Cloud Act.
Quel impact concret pour une PME ou une ETI ?
Pour un DSI ou un responsable technique, la gamme 5.5 appelle trois décisions :
- Fixer une politique de modèles. Par défaut, toute l'équipe tourne sur Opus 5.5 : un bon choix de qualité, dont il faut connaître le coût. Des réglages gérés par l'administrateur (
availableModels,maxEffortLevel) permettent de restreindre les modèles et de plafonner l'effort. - Router les tâches répétitives vers Haiku 5.5 (exploration, tri, extraction), en mesurant le taux d'erreur.
- Traiter Fable 5.1 comme une exception justifiée par une évaluation.
Pour une application métier qui appelle l'API, la méthode est la même : 50 à 100 cas réels, deux ou trois modèles, deux efforts, une comparaison en coût par tâche réussie. C'est la démarche que nous recommandons avant de figer le modèle d'un logiciel métier mis en production. Choisir les usages à outiller en premier relève d'un travail de stratégie IA. Pour les données qui ne doivent pas quitter la France, nous opérons nos propres serveurs GPU avec des modèles open-weight : c'est notre offre d'IA souveraine.
Ces arbitrages s'apprennent. Notre formation Claude Code pour développeurs (2 jours, 3 000 € HT en intra, 1 000 € HT par participant en inter, organisme certifié Qualiopi) couvre le suivi des coûts et la mesure du gain réel, sur le dépôt de l'équipe en intra. Pour comparer Claude Code à un outil ouvert, voyez notre comparatif des harness de code ; pour la gamme d'OpenAI, notre article sur GPT-6 en entreprise.
Les limites de ce comparatif
Les scores et coûts cités sont ceux d'Anthropic, mesurés sur ses bancs et avec ses réglages ; l'éditeur les dit lui-même indicatifs. Nous n'avons pas mené de banc d'essai indépendant.
Les prix sont des tarifs de liste en dollars, relevés le 14 octobre 2026 sur l'API d'Anthropic ; Bedrock et Google Cloud ont leur propre grille. Ils bougent vite : la lecture du cache de Sonnet 5.5, annoncée à 0,20 $ le 28 septembre, est passée à 0,10 $ le 7 octobre, et Claude Code n'a corrigé son calcul de coût que le 9 octobre. Quatre modèles en cinq semaines : cet article sera revu à chaque nouvelle version.
Conclusion : choisir un modèle, c'est d'abord choisir un effort et une mesure
La gamme 5.5 simplifie le choix par défaut. Opus 5.5 en medium couvre la majorité des usages de développement et de travail intellectuel, pour moins cher qu'Opus 5. Haiku 5.5 abaisse fortement le coût des traitements en volume, à condition de rester sous le seuil des 100 000 jetons. Fable 5.1 garde une place étroite, à justifier par la mesure.
La compétence utile n'est plus de connaître le « meilleur » modèle, qui change à chaque version, mais de mesurer sur vos propres tâches ce que coûte une réussite.
Lire aussi : Claude Code en équipe : ce que vos développeurs doivent apprendre
Sources
- Anthropic, annonces : Claude Opus 5.5 (22/09/2026), Claude Sonnet 5.5 (28/09/2026), Claude Haiku 5.5 (07/10/2026, avec la baisse du cache de Sonnet 5.5) et Claude Fable 5.1 et Mythos 5.1 (septembre 2026)
- Claude Platform Docs : Models overview et Choosing the right model (consultés le 14/10/2026)
- Claude Platform Docs : Pricing et Data residency (consultés le 14/10/2026)
- Claude Platform Docs : Optimizing for cost and intelligence (mesures d'Anthropic, consulté le 14/10/2026)
- Claude Platform Docs : What's new in Claude Opus 5.5, What's new in Claude Sonnet 5.5, What's new in Claude Haiku 5.5, What's new in Claude Fable 5.1 et Effort (consultés le 14/10/2026)
- Claude Code Docs : Model configuration, Subagents, Manage costs effectively, Amazon Bedrock et CHANGELOG (versions 2.1.257 du 01/09, 2.1.280 du 22/09, 2.1.292 du 06/10, 2.1.293 du 07/10 et 2.1.296 du 09/10/2026)
- Bedrock : Claude in Amazon Bedrock, Claude Platform Docs, AWS, Regional availability by models et fiches AWS de Claude Opus 5.5, Sonnet 5.5 et Haiku 5.5 (consultés le 14/10/2026)
Vos développeurs savent-ils sur quel modèle et à quel effort tourne leur Claude Code ? Vos applications paient-elles Opus pour trier des documents que Haiku traiterait ? Parlons-en : nous formons vos équipes à piloter Claude Code et ses coûts sur leur propre dépôt et nous mettons en production vos outils métier avec le modèle adapté à chaque tâche.